

Votre agent IA vous ment : comment les workflows permettent d'obtenir des résultats fiables
Temps de lecture : 20 minutes
Dans cet article, vous découvrirez comment l'équipe IA de Vonage a utilisé des workflows pour rendre les systèmes d'IA agentique plus prévisibles, reproductibles et prêts à être déployés en production.
L'IA générative est, par nature, probabiliste. Que l'on demande à un modèle d'IA de rédiger un e-mail, de résumer une réunion ou de générer du code, le fait que les résultats varient légèrement d'une exécution à l'autre ne pose généralement pas de problème. Dans de nombreuses tâches créatives ou exploratoires, cette variation fait partie intégrante de la valeur apportée.
Les systèmes d'analyse sont différents.
Lorsque les systèmes d'IA sont utilisés pour classer les employés, générer des rapports opérationnels, analyser les interactions avec les clients ou identifier les tendances commerciales, la cohérence est essentielle. Si une même requête portée sur les mêmes données produit à chaque fois des résultats différents, il devient difficile de se fier à ces résultats ou de prendre des décisions en s'appuyant sur eux.
Lors d'expériences menées en interne chez Vonage, nous avons pu le constater de nos propres yeux alors que nous mettions en place des flux d'analyse basés sur l'IA pour les données relatives à l'expérience client. Lors d'un premier test, un agent a classé Maria en tête des représentants du service client. Quinze minutes plus tard, avec la même configuration, le même système a classé James en première position. Un troisième test a désigné Priya comme la meilleure.
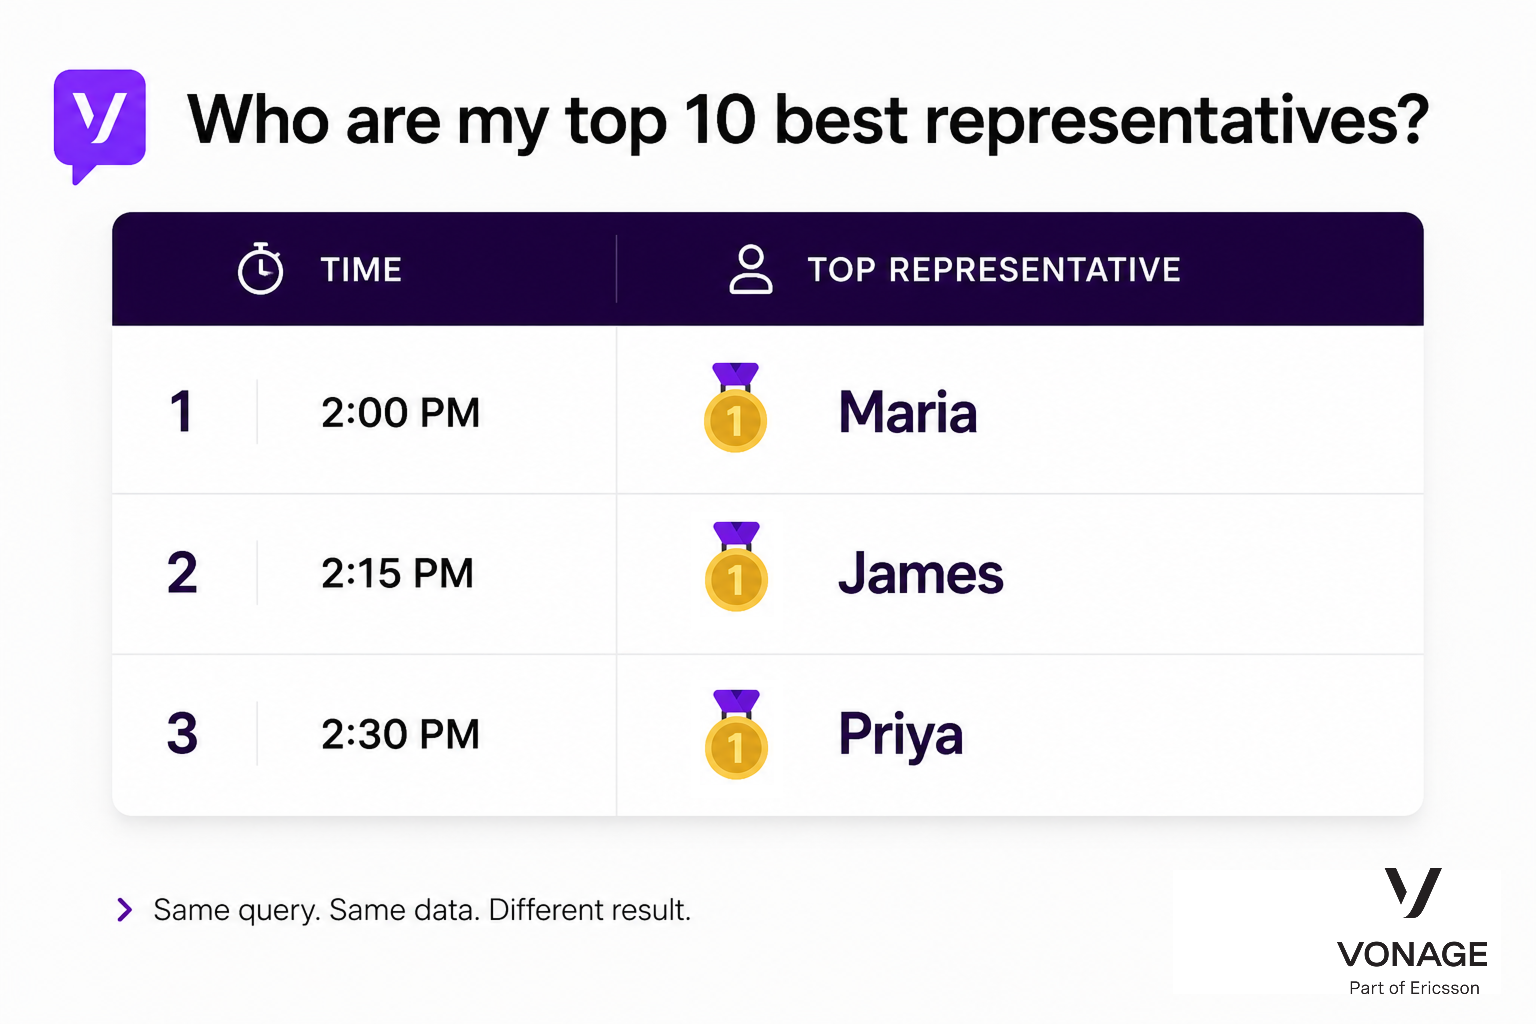 The same AI analytics query produced different top-ranked representatives across repeated runs, despite using the same dataset and prompt.
Dans le cadre d'une analyse exploratoire, ce type de variabilité peut être acceptable. En revanche, pour les tableaux de bord programmés, les revues opérationnelles, les processus d'assurance qualité ou les rapports de conformité, des résultats incohérents constituent rapidement un problème de production.
Cela a soulevé une question importante pour l'équipe d'IA de Vonage : comment rendre les systèmes agentiques plus prévisibles lorsque la cohérence est essentielle ?
Pour étudier cette question, nous avons mené une série d'expériences comparant l'exécution standard par des agents à des parcours d'exécution guidés par des flux de travail, conçus pour verrouiller la méthodologie analytique, réduire les dérives de raisonnement et améliorer la reproductibilité. Les résultats ont montré que les flux de travail peuvent améliorer considérablement la cohérence des systèmes analytiques basés sur l'IA sans pour autant supprimer la flexibilité qui fait justement l'intérêt des agents.
Les systèmes agentiques modernes ne se contentent pas de générer du texte. Ils analysent les problèmes, choisissent des méthodologies analytiques, écrivent du code intermédiaire, effectuent des calculs et déterminent la manière dont les résultats doivent être présentés.
De légères différences dans le raisonnement, survenant au début d'une boucle d'exécution agentique, peuvent s'accumuler et aboutir à des résultats sensiblement différents plus tard dans le processus.
Au cours de nos expériences, nous avons observé à plusieurs reprises le même phénomène : des requêtes identiques portées sur des ensembles de données identiques donnaient des résultats différents d'une exécution à l'autre. Une requête telle que :
« Qui sont mes 10 meilleurs représentants ? »
pourrait désigner trois collaborateurs parmi les meilleurs en l'espace d'une demi-heure.
Les données sous-jacentes n'ont jamais changé. Ce qui a changé, c'est le processus de raisonnement de l'agent.
Pour répondre à une requête de ce type, un agent doit prendre une série de décisions avant même d'écrire la moindre ligne de code d'analyse :
Quels sont les indicateurs les plus importants ?
Comment ces indicateurs devraient-ils être pondérés ?
Comment faut-il normaliser les valeurs ?
Quels seuils ou filtres faut-il appliquer ?
Comment les résultats finaux doivent-ils être présentés ?
Ces décisions ne sont pas explicitement définies dans la consigne. Le modèle les déduit au cours de l'exécution, et de légères différences dans le raisonnement peuvent conduire à des approches analytiques différentes.
Dans un scénario, l'agent peut donner la priorité aux scores relatifs au sentiment des clients et à l'empathie. Dans un autre, il peut accorder plus d'importance au taux de résolution ou exclure complètement les agents ayant un faible volume d'activité. Il en résulte un chemin de calcul différent et, au final, un classement différent.
Ce type de variabilité reste gérable au stade de l'exploration. Mais dans les systèmes de production — où les rapports, les tableaux de bord, les Audits et les décisions opérationnelles reposent sur la cohérence —, cela devient un problème de fiabilité.
La plupart des agents d'IA modernes utilisent un modèle de raisonnement communément appelé ReAct (Reason → Act → Observe). Au lieu de générer une réponse unique, l'agent suit une séquence de décisions et d'appels d'outils.
Voici à quoi pourrait ressembler un flux d'exécution simplifié :
Raison → Comprendre l'ensemble de données
Agir → Interroger les colonnes disponibles
Observer → Examiner les caractéristiques disponibles
Raison → Sélectionner les indicateurs et la méthodologie
Agir → Générer le code d’analyse
Observer → Évaluer les résultats
Raison → Mettre en forme la réponse finale
Chaque étape du raisonnement crée une nouvelle possibilité de divergence.
Un petit changement en début de processus — comme le choix d'indicateurs différents ou l'attribution de pondérations légèrement différentes — peut modifier toutes les étapes en aval. L'agent peut générer un code d'analyse différent, appliquer des filtres différents ou calculer les scores différemment, même si la requête et l'ensemble de données d'origine restent identiques.
Le schéma ci-dessous montre comment une seule décision de raisonnement peut orienter l'agent vers des chemins d'exécution totalement différents.
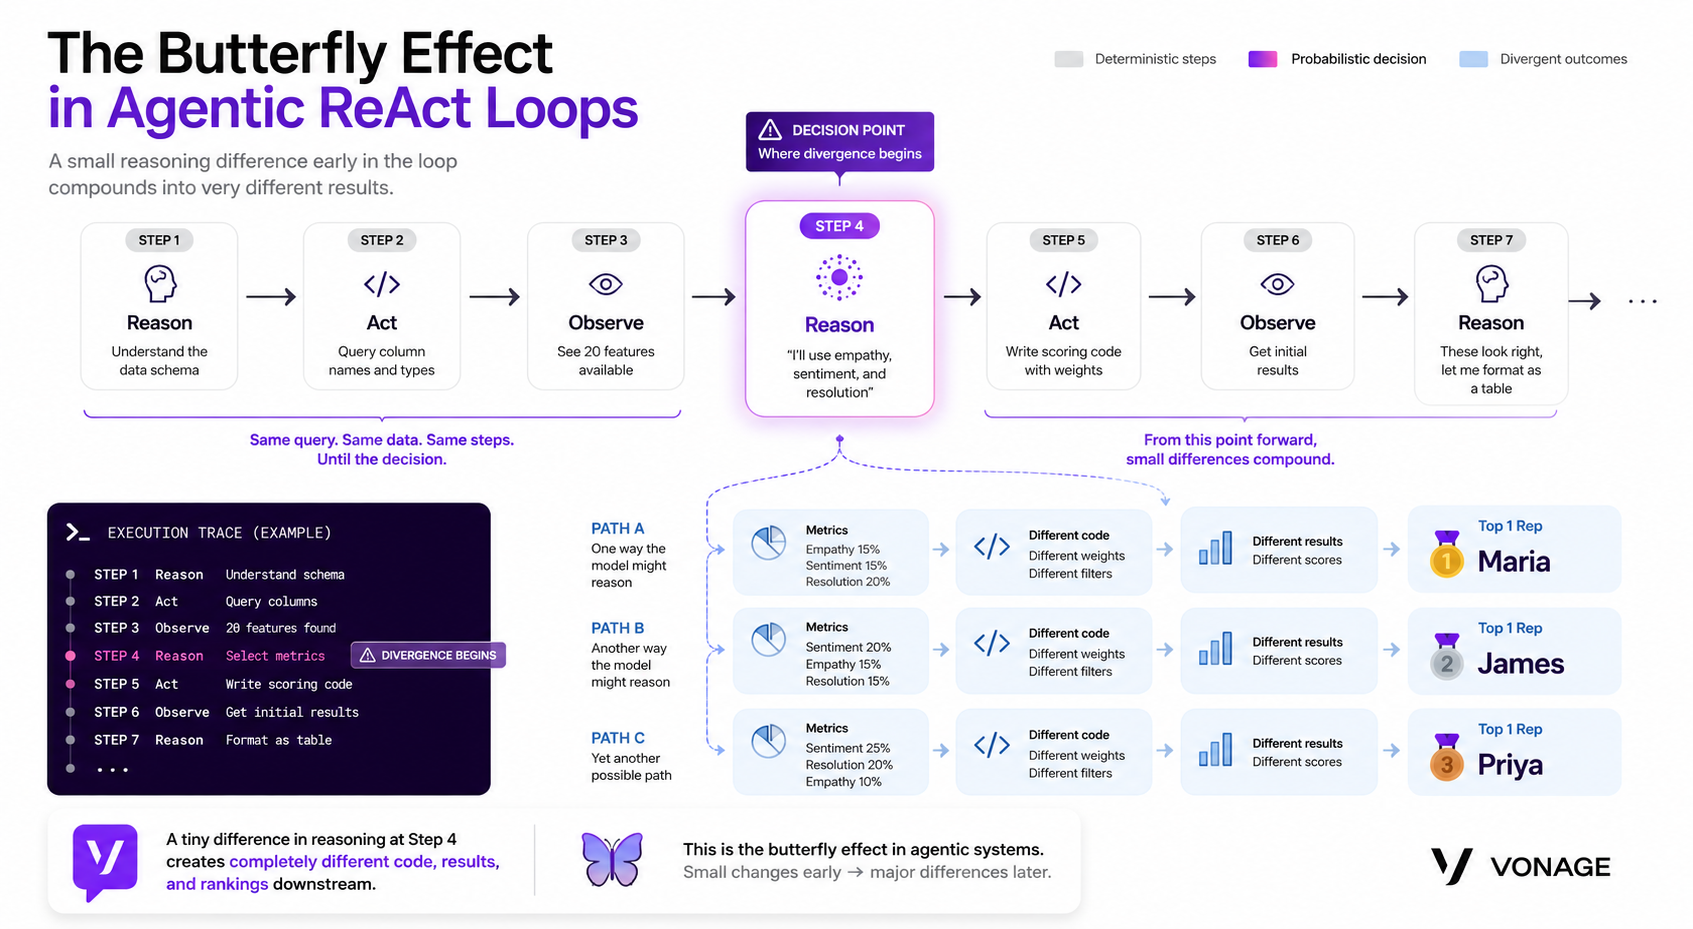 A small reasoning difference inside a ReAct loop can compound into different analytical methodologies, calculations, and final outputs across repeated agent runs.
Cet effet cumulatif constitue l'un des principaux défis des systèmes d'agent de production. Plus la chaîne de raisonnement s'allonge, plus les résultats risquent de varier d'une exécution à l'autre.
Afin de réduire cette variabilité, nous avons cherché à déterminer si les processus de travail pouvaient limiter les éléments du système les plus responsables de la dérive analytique.
Au lieu de laisser l'agent inventer une nouvelle méthodologie à chaque exécution d'une requête, un workflow fournit un chemin d'exécution prédéfini basé sur un « cycle de référence » validé. Le workflow préserve la structure analytique qui a permis d'obtenir un résultat fiable, notamment :
indicateurs sélectionnés
logique de calcul
seuils et filtres
structure et mise en forme de la sortie
Remarque >> Retrouvez la configuration complète de l'expérience et la série de tests de référence dans le référentiel GitHub.
L'agent continue d'effectuer l'analyse et d'interagir avec les données en temps réel, mais les décisions méthodologiques essentielles ne sont plus redéfinies à chaque exécution.
Une étape simplifiée du flux de travail pourrait se présenter comme suit :
ÉTAPE 2 : Agrégation des indicateurs de performance des agents
OBJECTIF : Calculer les indicateurs de performance moyens pour l'ensemble des appels
ACTION : Regrouper par agent_id et calculer les moyennes
RÉSULTAT : ensemble de données de notation cohérent pour le classement
L'objectif n'était pas de rendre les agents déterministes au sens traditionnel du terme en informatique. Nous souhaitions plutôt vérifier si les flux de travail pouvaient limiter suffisamment la dérive du raisonnement pour rendre les résultats analytiques plus stables, reproductibles et prêts à être utilisés en production.
Afin de déterminer si les flux de travail pouvaient réduire la variabilité dans les systèmes d'agents analytiques, nous avons mené une série d'expériences contrôlées à partir de données réelles issues de l'expérience client.
Nous avons testé à plusieurs reprises les mêmes requêtes analytiques sur un ensemble de données provenant d'un centre d'appels et contenant :
environ 3 900 interactions avec les clients
33 conseillers du service client
20 caractéristiques de performance extraites
Toutes les expériences ont été réalisées avec Claude Opus 4.5 via AWS Bedrock, en utilisant les paramètres de température par défaut.
Pour chaque cas de test, nous avons d'abord exécuté la requête 10 fois en utilisant un flux d'exécution standard par agent. Nous avons ensuite créé un workflow à partir d'une « exécution de référence » validée, puis nous avons exécuté ce workflow 10 fois supplémentaires sur le même ensemble de données.
L'objectif : mesurer l'ampleur des variations des résultats d'une exécution à l'autre, et déterminer si des flux de travail pourraient réduire cette dérive.
Remarque >> Le montage exact de l'expérience est présenté dans l' annexe sur GitHub.
Notre première expérience portait sur une requête analytique simple :
« Qui sont mes 10 meilleurs commerciaux selon les indicateurs de performance globaux ? »
À première vue, cela semble simple. Mais l'agent doit tout de même prendre plusieurs décisions analytiques avant de pouvoir établir un classement :
Quels sont les indicateurs les plus importants ?
Comment ces indicateurs devraient-ils être pondérés ?
Comment faut-il normaliser les notes ?
Quels filtres ou seuils faut-il appliquer ?
En l'absence de processus de travail, ces décisions variaient d'une exécution à l'autre.
Au cours de 10 exécutions indépendantes de la même requête, l'agent a généré à plusieurs reprises des approches analytiques différentes. Il a modifié la pondération des indicateurs, utilisé différentes échelles de notation et fait varier le nombre de facteurs de performance pris en compte dans le classement.
Dans certaines simulations, la satisfaction client a eu le plus de poids. Dans d’autres, le taux de résolution est devenu le facteur déterminant. Certaines simulations utilisaient une échelle de notation de 0 à 1, tandis que d’autres ont opté pour une échelle de 0 à 100.
Ces légers changements méthodologiques ont donné lieu à des résultats différents. Trois représentants différents ont occupé la première place au cours des 10 essais.
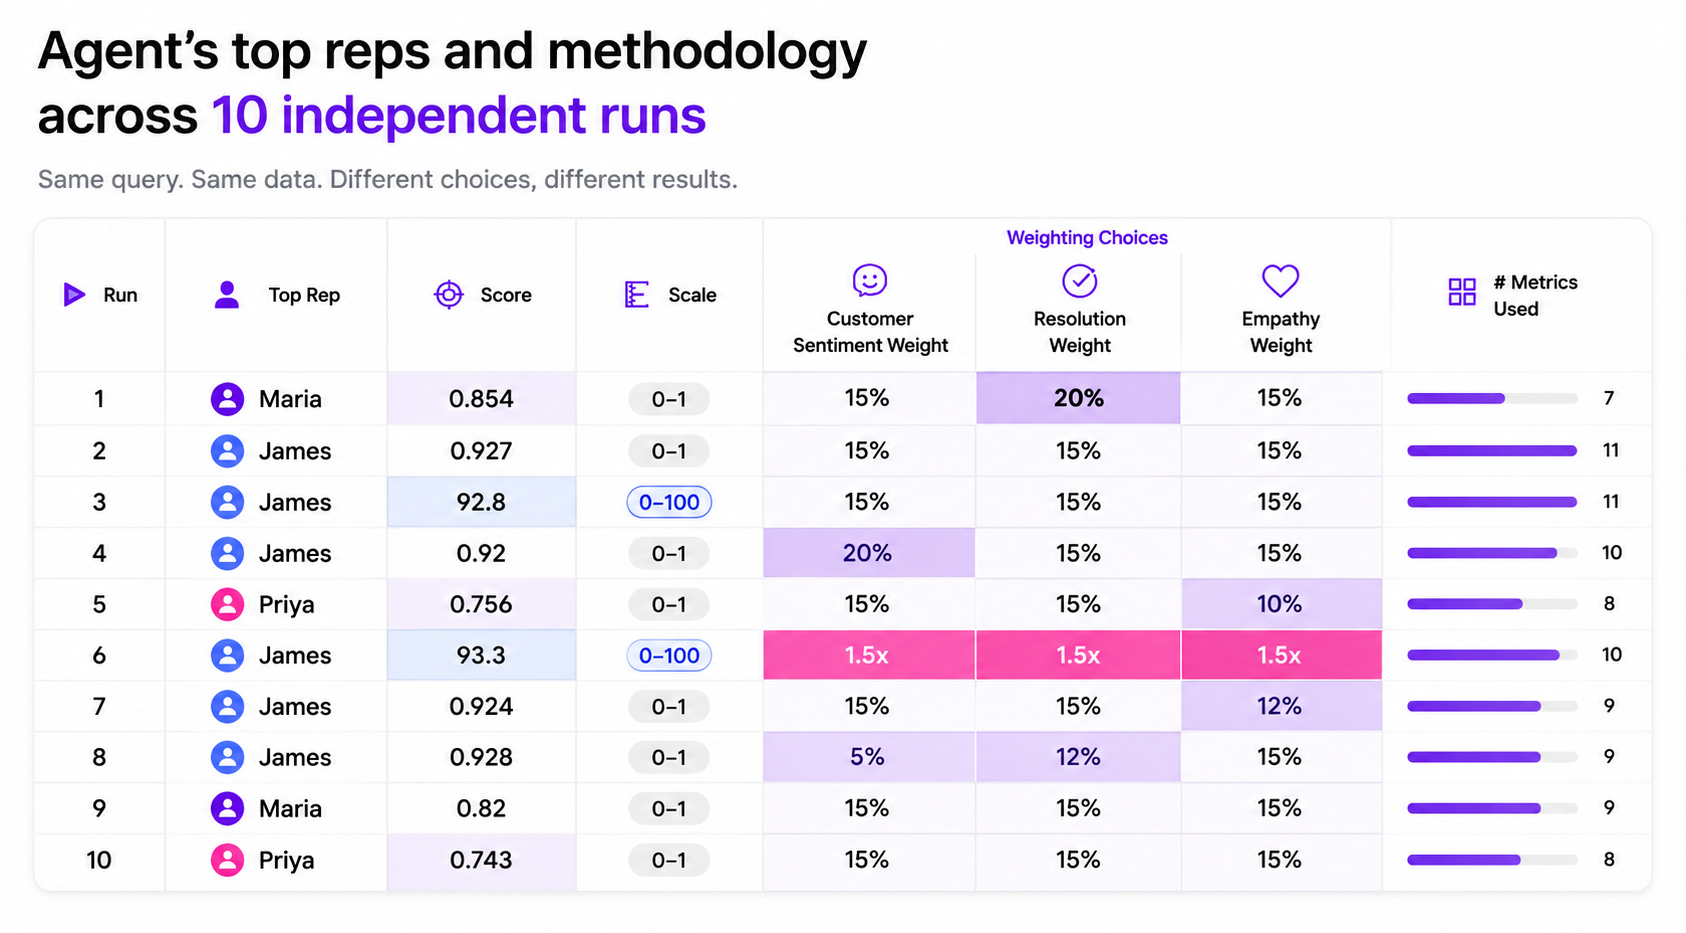 Repeated executions of the same AI ranking query produced different scoring methodologies, metric weights, and top-ranked representatives across 10 independent runs.
Cette variabilité n'était pas due à des données changeantes. La variation du classement provenait du fait que l'agent réinterprétait en permanence la manière dont l'analyse elle-même devait fonctionner.
Afin de déterminer si les flux de travail permettaient de réduire cette dérive, nous avons répété l'expérience en utilisant un flux de travail généré à partir d'un « cycle de référence » validé.
En l'absence de workflow, les classements variaient considérablement d'une exécution à l'autre. Différents représentants apparaissaient, disparaissaient ou changeaient radicalement de position d'une exécution à l'autre. Certaines exécutions renvoyaient même moins de 10 résultats, car l'agent formatait la réponse différemment.
Une fois le processus mis en place, les classements sont devenus nettement plus stables. Le même représentant occupait la première place à chaque exécution du processus, le même représentant occupait la deuxième place à chaque exécution du processus, et le classement complet des 10 premiers représentants restait identique d'une exécution à l'autre.
Seules des différences mineures dans le classement ont été observées aux places inférieures.
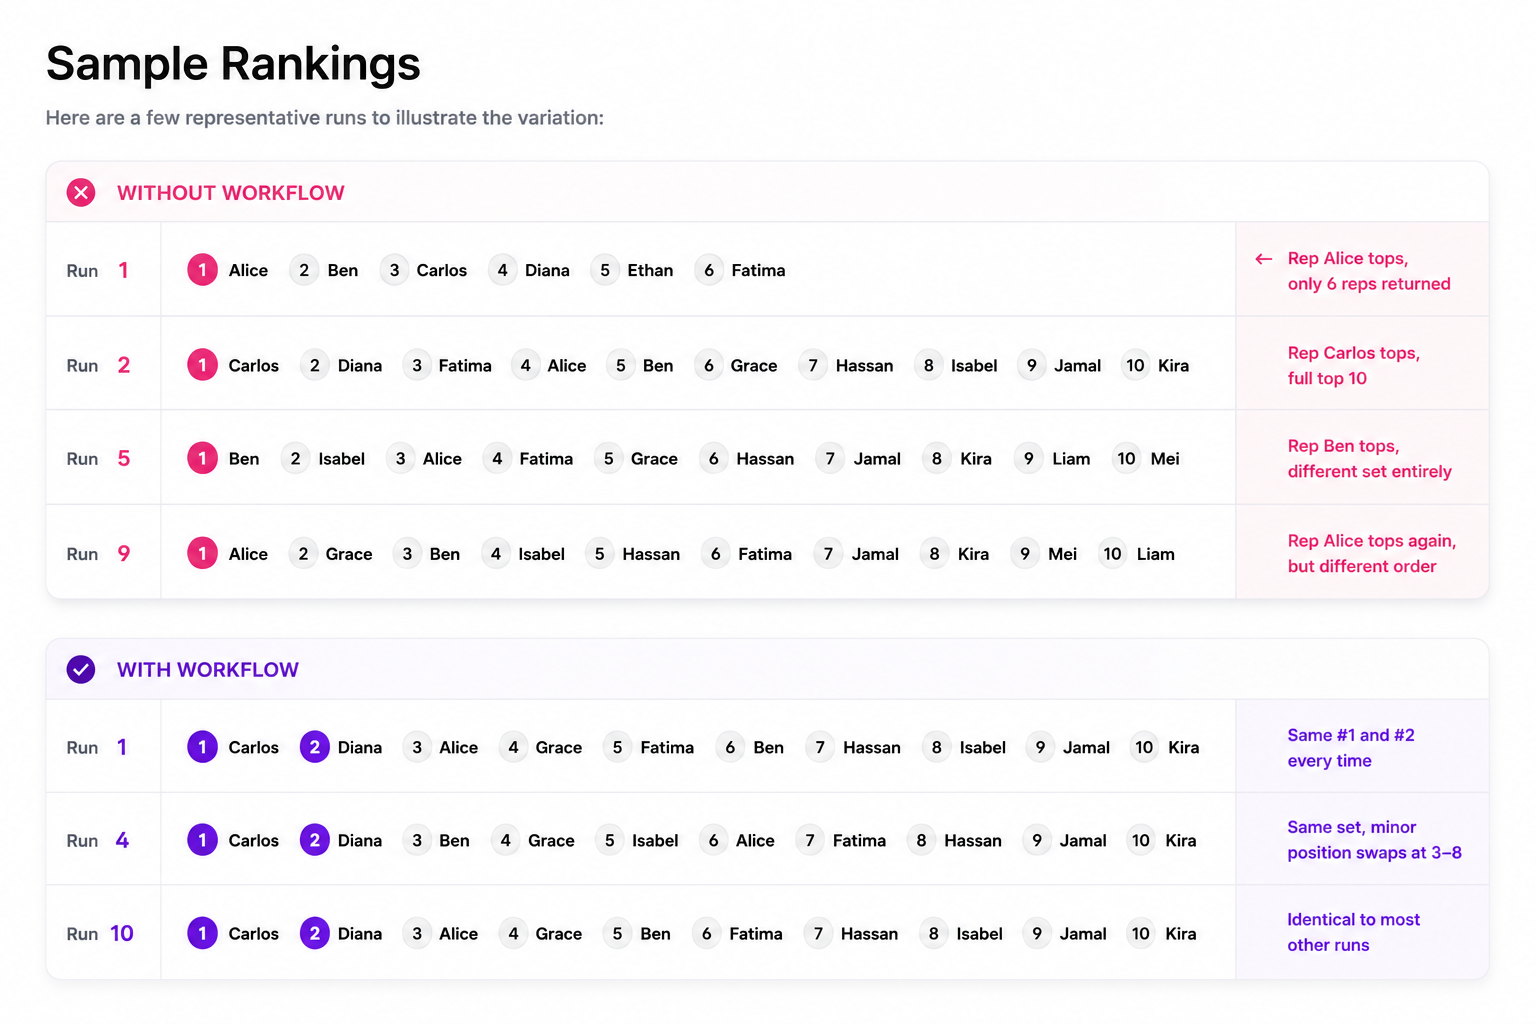 Workflow-constrained executions produced significantly more stable ranking results across repeated runs compared to fully dynamic agentic execution.
Les améliorations en matière de cohérence ont été mesurables pour tous les indicateurs de classement que nous avons évalués :
Le taux de cohérence « Top-1 » est passé de 60 % à 100 %
Le chevauchement du Top 10 s'est avéré parfaitement stable d'une exécution à l'autre du flux de travail
La similitude des classements a augmenté de manière significative d'une exécution à l'autre
Les workflows ont permis de réduire à la fois la dérive des classements et la dérive méthodologique. Nous reviendrons sur deux implications importantes (l'exactitude et la vitesse d'exécution) dans la section « Conclusions ».
Notre deuxième expérience visait à évaluer dans quelle mesure l'agent était sensible aux légères variations dans la formulation en langage naturel.
Nous avons posé la même question de quatre façons légèrement différentes :
« Qui sont mes 10 meilleurs commerciaux ? »
« Montrez-moi les 10 commerciaux les plus performants »
« Classez les 10 meilleurs commerciaux en fonction de leurs performances »
« Quels commerciaux affichent les meilleurs résultats ? »
Chaque variante a été exécutée à plusieurs reprises, avec et sans workflows.
En l’absence de processus de travail, ces légères modifications de formulation entraînaient souvent des différences notables dans le comportement analytique. Des expressions telles que « meilleurs commerciaux », « plus performants » et « meilleurs indicateurs » incitaient l’agent à interpréter la tâche de différentes manières. Dans certaines séries de tests, l’analyse se concentrait davantage sur des indicateurs clés de performance (KPI) mesurables, tels que le taux de résolution, tandis que d’autres séries mettaient l’accent sur le sentiment ou sur une notation composite plus large.
En général, les humains considèrent ces expressions comme équivalentes. Ce n'était pas le cas de l'agent.
Une fois les workflows activés, la formulation a perdu beaucoup de son importance, car la méthodologie d'exécution était déjà définie. Au lieu de réinventer l'analyse pour chaque variante de formulation, le système réutilisait le même chemin d'exécution validé.
Les résultats ont montré des améliorations mesurables tant au niveau de la cohérence que de la stabilité de l'exécution.
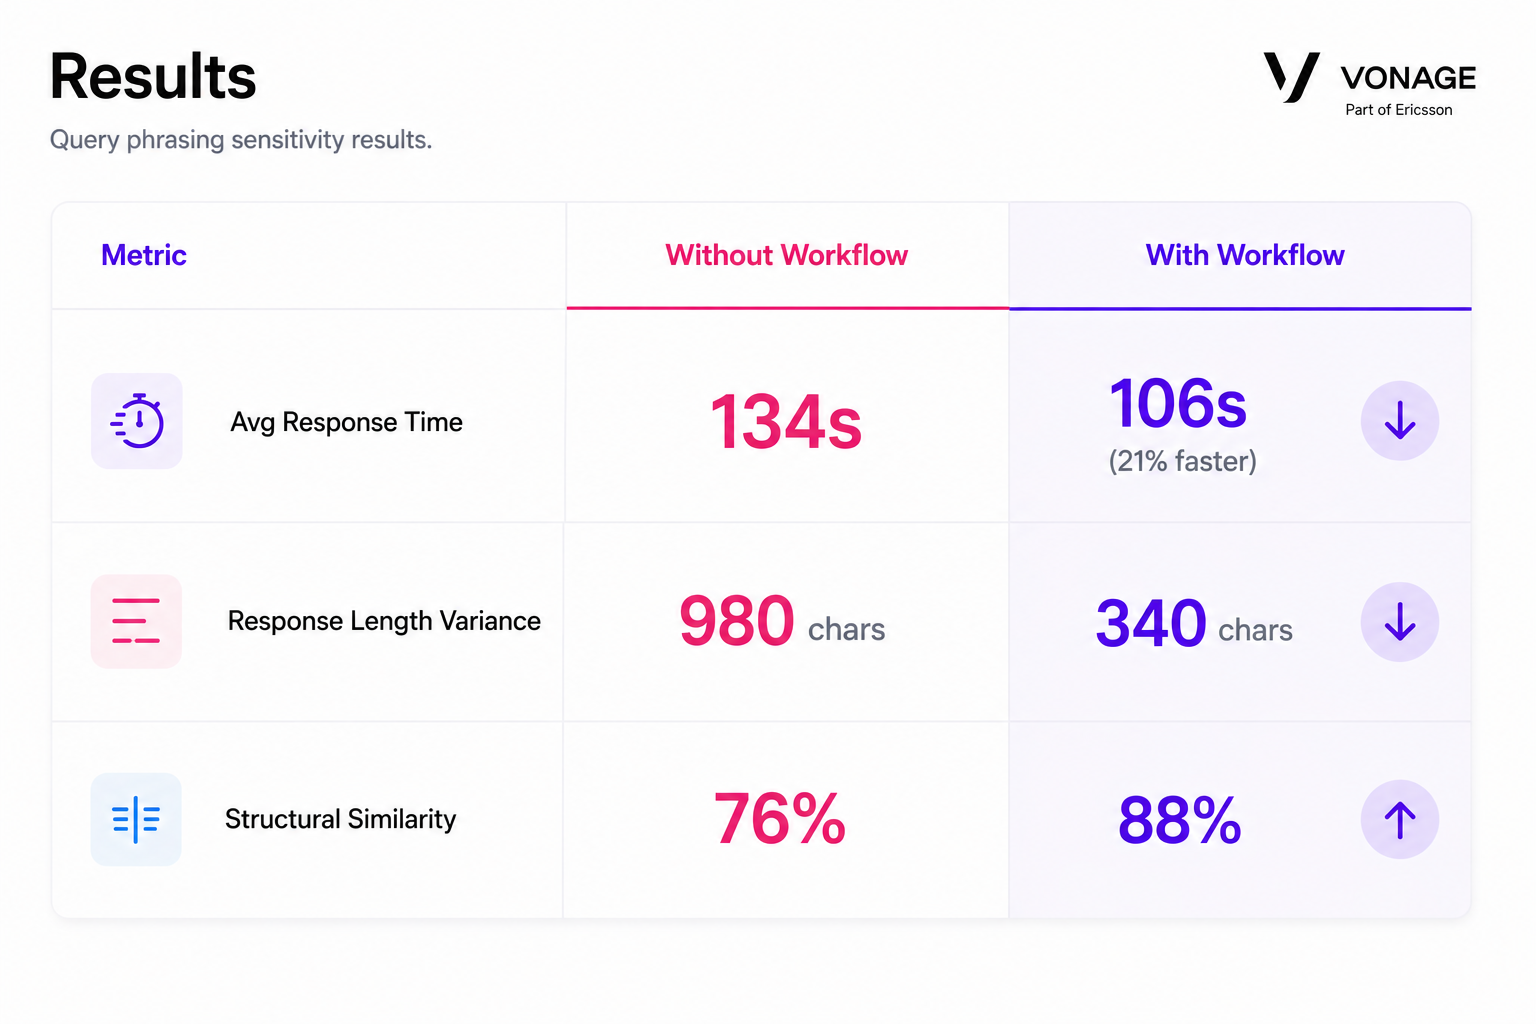 Workflow-constrained executions produced more consistent analytical structures and response formats across different phrasings of the same query.
Les workflows ont permis de réduire l'impact de l'ambiguïté linguistique et de rendre le comportement du système plus prévisible face à des requêtes sémantiquement similaires.
La variabilité des classements est facile à remarquer. La dérive d'agrégation est souvent plus difficile à détecter, mais elle s'avère bien plus dangereuse dans les systèmes de reporting en production.
Afin d'évaluer la manière dont les agents géraient des tâches analytiques plus complexes, nous avons exécuté à plusieurs reprises la requête suivante sur le même ensemble de données :
« Calculer le score moyen de sentiment par call_reason_category, et identifiez les catégories qui présentent une tendance à la baisse. »
Contrairement à une simple requête de classement, ce type de requête oblige l'agent à prendre plusieurs décisions analytiques à différents niveaux au cours de son exécution :
Comment faut-il regrouper les catégories ?
Comment faut-il calculer les moyennes ?
Comment faudrait-il définir le terme « en déclin » ?
Quels filtres ou seuils faut-il appliquer ?
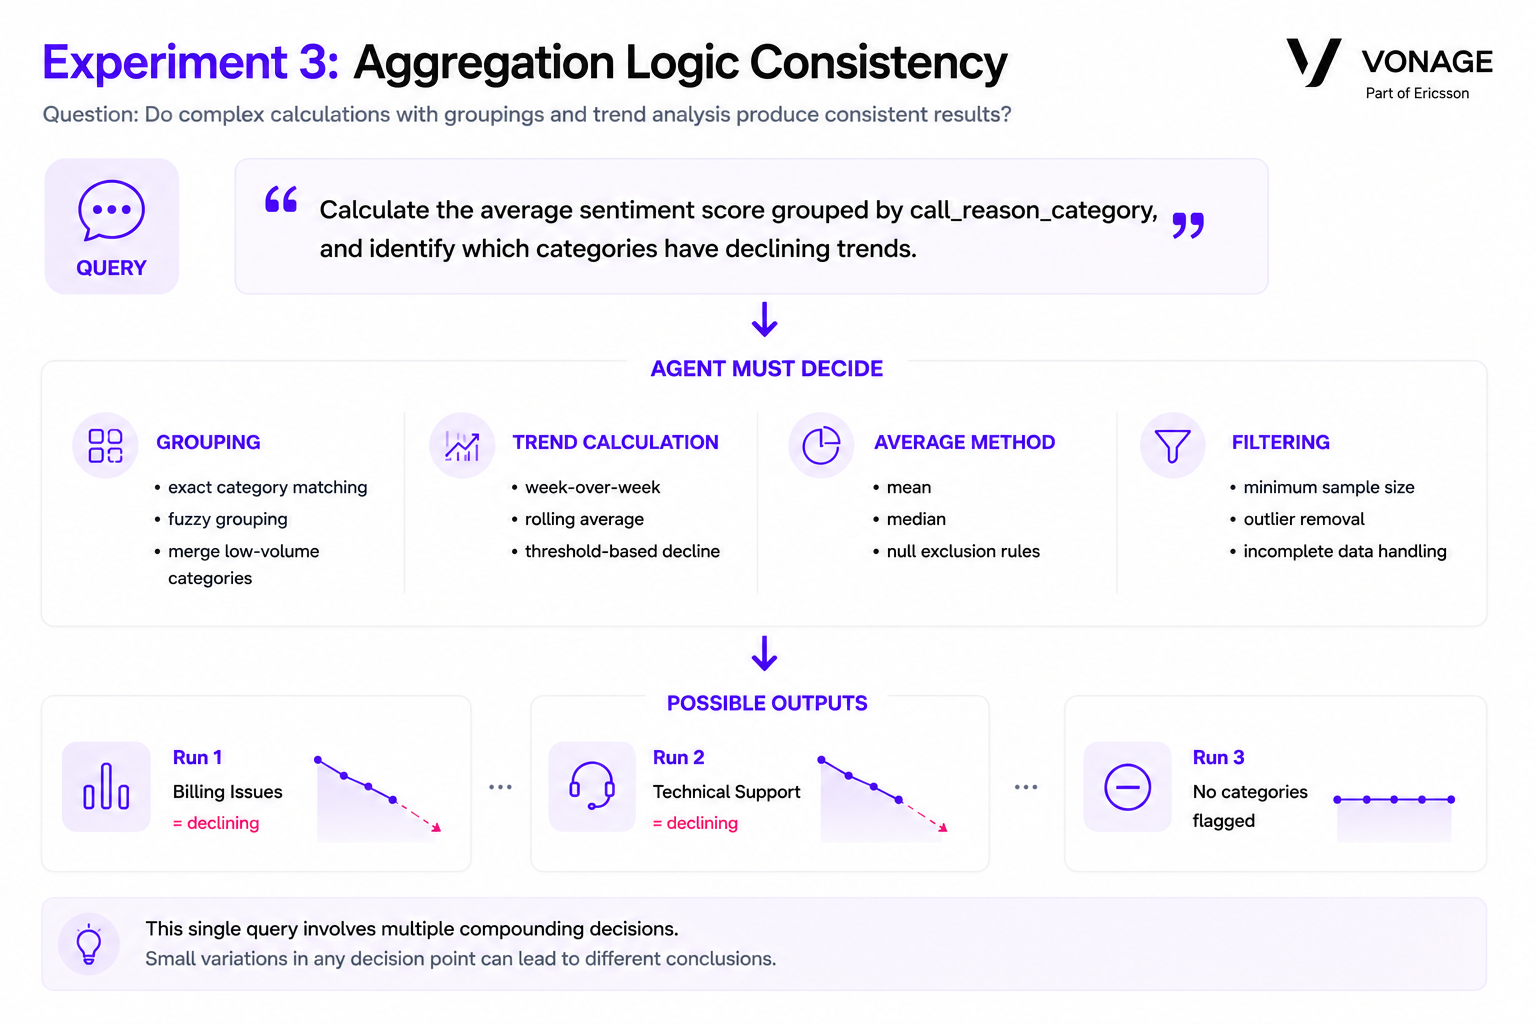 Complex aggregation queries require agents to make multiple methodological decisions that can lead to inconsistent analytical outcomes across repeated runs.
En l'absence de workflows, ces décisions variaient sensiblement d'une exécution à l'autre. Certaines exécutions utilisaient des plages horaires différentes pour l'analyse des tendances ; d'autres regroupaient les catégories différemment ; certaines excluaient totalement les catégories à faible volume, tandis que d'autres les incluaient.
Par conséquent, une même catégorie peut apparaître comme « en baisse » lors d’une analyse et comme « stable » lors d’une autre, alors même que les données n’ont pas changé.
Ce type de variabilité revêt une importance particulière, car les requêtes d'agrégation occupent une place centrale dans les systèmes de reporting opérationnel. Les tableaux de bord, l'analyse des indicateurs clés de performance (KPI), les rapports de conformité et les synthèses destinées à la direction reposent tous sur des calculs produisant des résultats cohérents dans le temps.
Une fois les workflows activés, la méthodologie d'agrégation est restée stable d'une exécution à l'autre. La logique de regroupement, les calculs de tendance, les seuils et les règles de filtrage ont été conservés à partir de la définition validée du workflow, ce qui a permis d'obtenir des résultats reproductibles lors d'exécutions répétées.
Les workflows ont permis de réduire le risque de dérive analytique dans les scénarios de reporting où la cohérence n'est pas seulement utile, mais également exigée par la loi.
Notre dernière expérience portait sur des requêtes comportant des critères délibérément ambigus ou contradictoires.
Nous avons demandé à l'agent :
« Identifiez les commerciaux présentant des risques en matière de conformité tout en affichant un niveau élevé de satisfaction client. »
Ce type de demande revient fréquemment dans le domaine de l'analyse opérationnelle. Les équipes doivent souvent identifier des combinaisons inhabituelles de signaux, comme par exemple des collaborateurs qui suscitent des retours clients très positifs tout en suscitant des inquiétudes accrues en matière de conformité.
La difficulté réside dans le fait que des termes tels que « niveau élevé de satisfaction client » et « risque de non-conformité » ne sont pas définis mathématiquement dans la requête elle-même. L'agent doit déterminer, au moment de l'exécution, ce que ces seuils signifient.
En l'absence de workflows, ces définitions variaient considérablement d'une exécution à l'autre.
Dans certains cas, une « grande satisfaction » correspondait à des notes supérieures à 4,5. Dans d’autres, le seuil descendait jusqu’à environ 3,0. La définition du « risque de conformité » variait également en fonction de la manière dont l’agent interprétait les signalements, les conclusions d’Audit ou les violations des politiques.
En conséquence, cette même requête renvoyait entre 5 et 16 représentants.
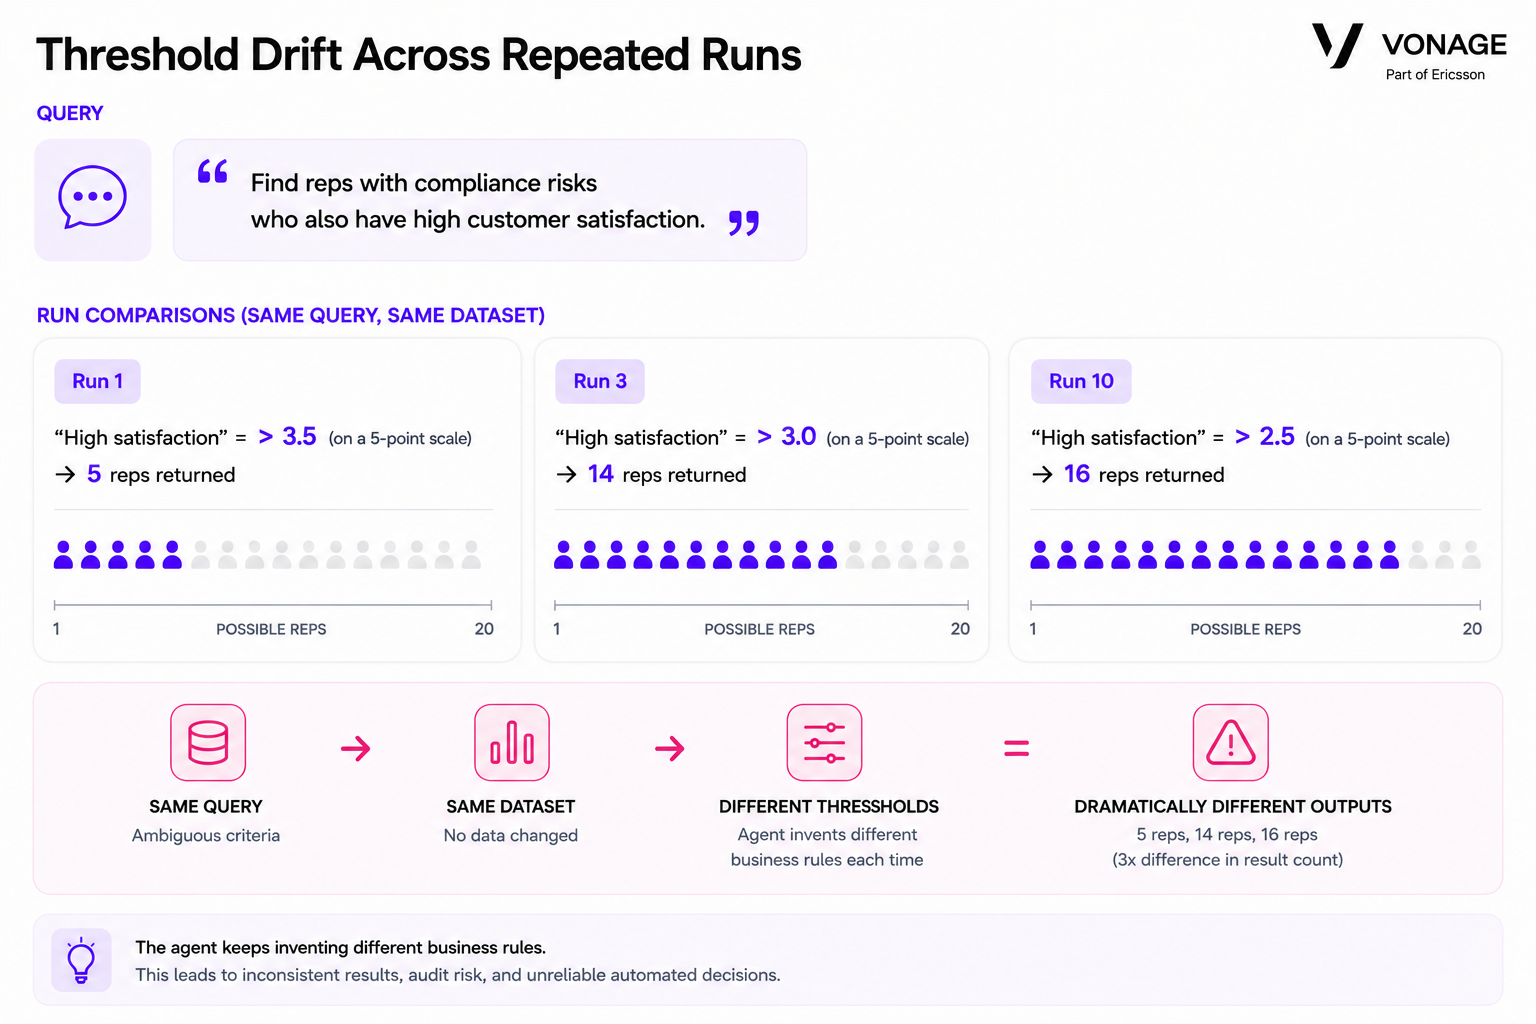 Ambiguous analytical criteria caused the AI agent to apply different thresholds across repeated runs, producing significantly different result counts from the same query and dataset.
Une fois les workflows activés, ces seuils ont été conservés à partir de la définition validée du workflow, ce qui a permis d'obtenir des résultats nettement plus stables d'une exécution à l'autre.
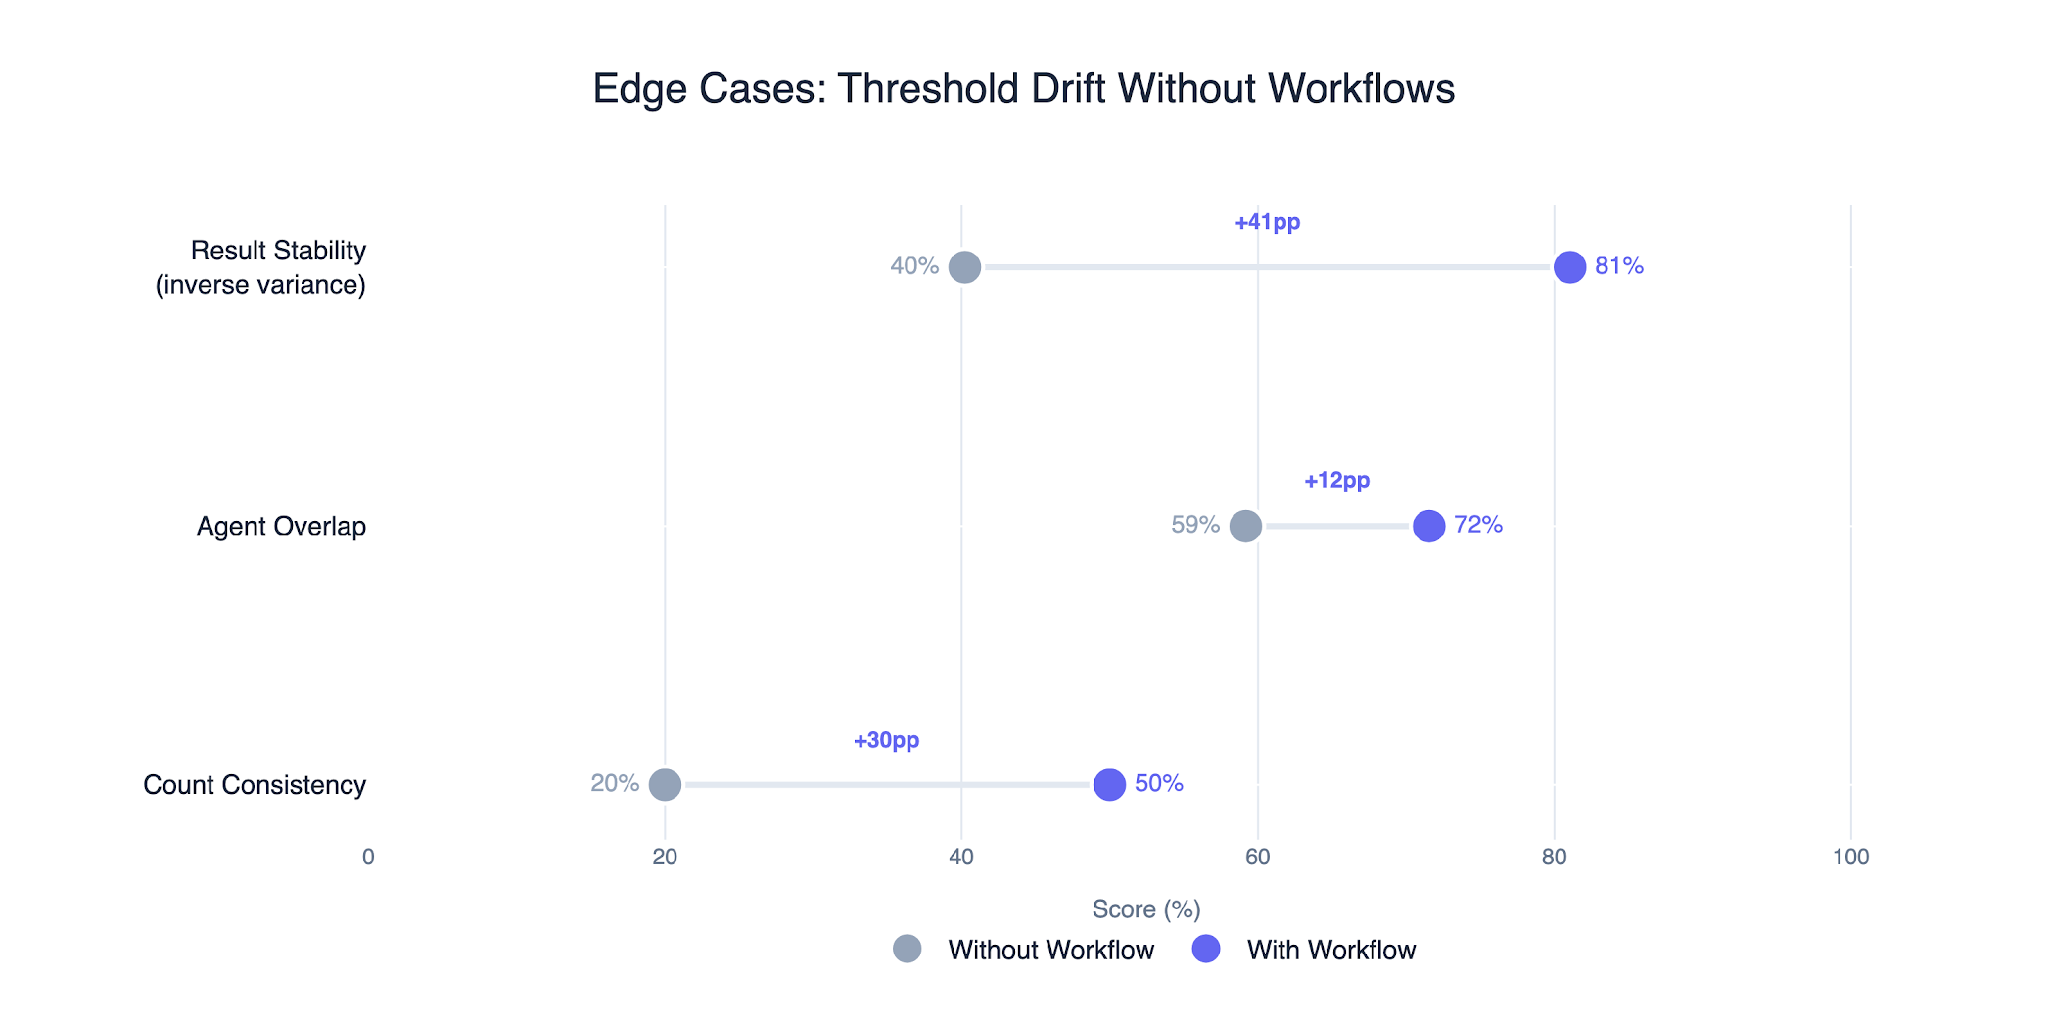 Workflows improved consistency and result stability for ambiguous edge-case queries by preserving threshold definitions across repeated runs.
Même avec les workflows, les cas limites sont restés plus difficiles à stabiliser que les expériences de classement présentées plus haut dans cet article. Le langage métier, par nature ambigu, introduit naturellement davantage de variance que des tâches analytiques clairement définies.
Toutefois, ces flux de travail ont tout de même permis de réduire considérablement la dérive des seuils et d'améliorer la cohérence dans les domaines suivants :
nombre de résultats
recoupement représentatif
stabilité de la sortie
C'est important pour les systèmes opérationnels tels que :
détection des anomalies
rapports d'audit
contrôles de conformité
systèmes d'alerte automatisés
Dans ces environnements, des seuils incohérents peuvent entraîner des faux positifs, des faux négatifs ou des ensembles de résultats signalés totalement différents d'une exécution à l'autre.
Au cours des quatre expériences, l'agent n'a cessé de modifier sa manière de mener l'analyse. Chaque fois qu'il devait prendre une décision ambiguë, il introduisait une variabilité dans les résultats.
En l'absence de workflows, les agents modifiaient sans cesse leur approche de l'analyse proprement dite. Ils choisissaient des indicateurs différents, ajustaient les seuils, interprétaient les formulations de manière différente et modifiaient la logique de regroupement ou de filtrage d'une exécution à l'autre, même lorsque la requête et l'ensemble de données d'origine restaient inchangés.
Ces flux de travail ont permis de réduire cette variabilité en conservant la méthodologie analytique issue d'un « cycle de référence » validé.
La principale source d'incohérence résidait dans l'évolution de la méthodologie analytique au sein même du système.
Au cours des différentes expériences, les agents ont régulièrement dévié de leur trajectoire dans des zones telles que :
pondération métrique
définitions des seuils
logique de regroupement
règles de filtrage
calculs de tendance
formules de calcul des notes
Chaque petite modification apportée au raisonnement a entraîné des différences en aval au niveau de la génération de code, des calculs, des classements et des résultats.
Les flux de travail ont encadré ces décisions en préservant :
indicateurs fixes
seuils fixes
chemins de calcul fixes
ordre d'exécution fixe
Au lieu de redéfinir la méthodologie à chaque exécution, le système a réutilisé un processus analytique validé.
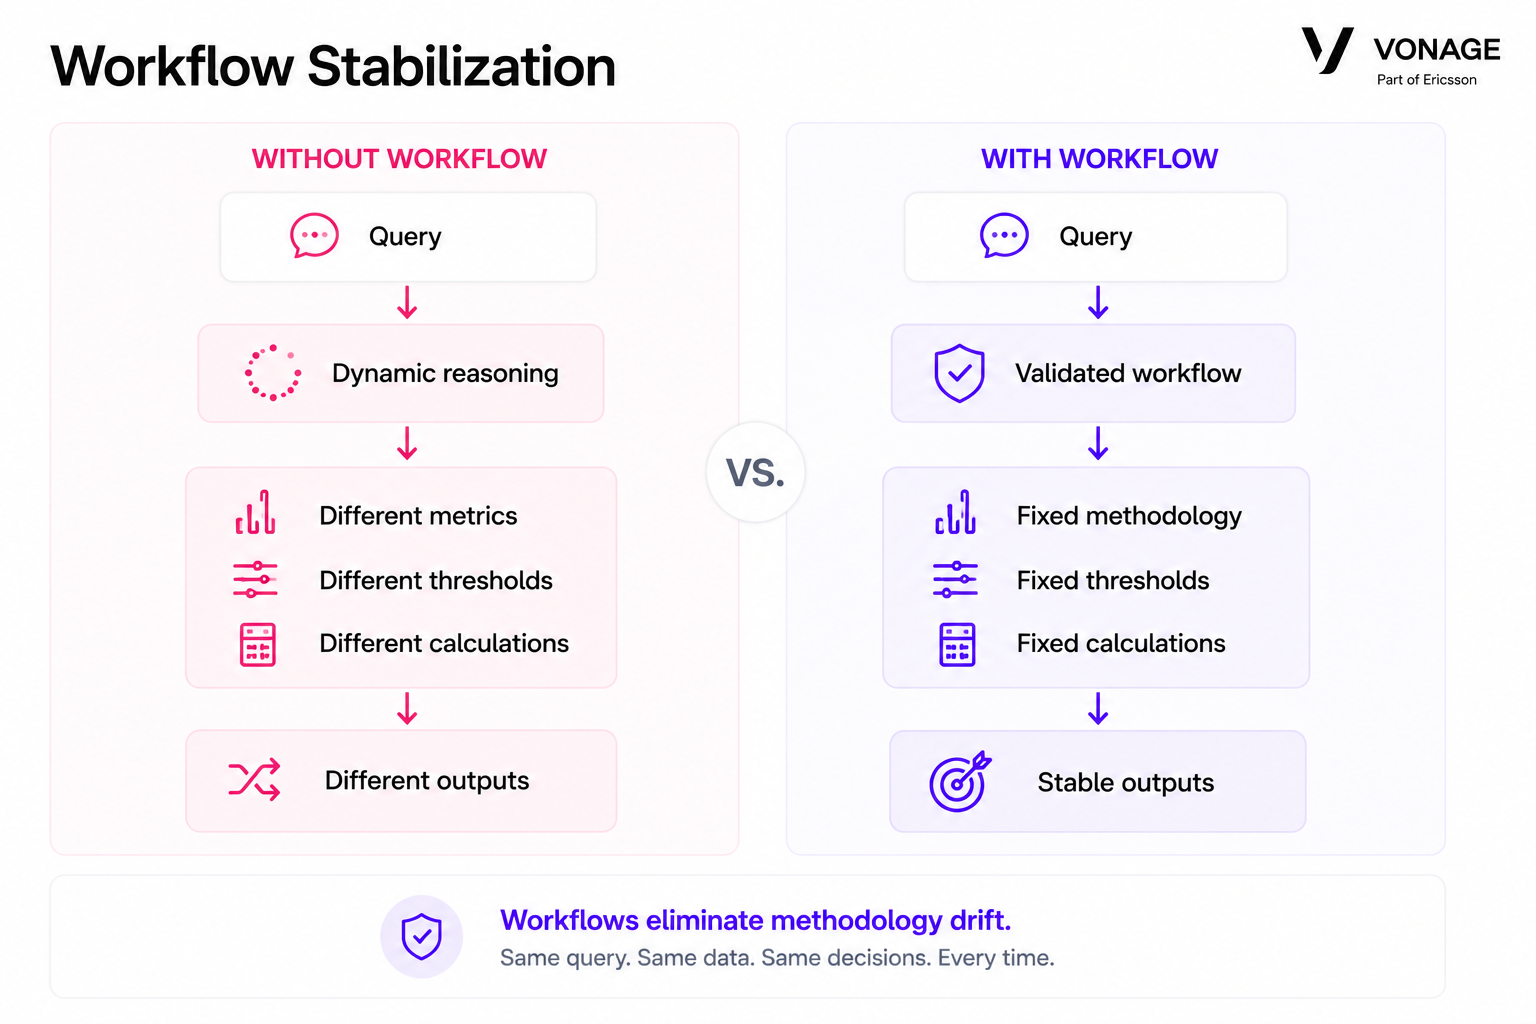 Workflows stabilize AI analytical systems by preserving validated methodologies, thresholds, and calculations across repeated executions."Cela a permis de réduire à la fois la dérive du raisonnement et la dérive des résultats au fil des exécutions répétées.
L'impact est apparu clairement. Une fois les flux de travail activés, nous avons constaté :
des classements plus stables
résultats d'agrégation reproductibles
un nombre plus prévisible de résultats
moins de variations de mise en forme
une structure analytique plus cohérente
C'est important car les systèmes de production reposent sur la stabilité des résultats dans le temps. Les tableaux de bord, les systèmes d'assurance qualité, les contrôles de conformité et les pipelines de reporting automatisés partent tous du principe qu'une même requête portée sur les mêmes données doit produire des résultats sensiblement similaires.
Sans cette cohérence, il devient difficile de se fier aux systèmes en aval.
Les expériences ont également montré que les flux de travail étaient plus efficaces lorsque la tâche analytique elle-même était bien définie. Les tâches de classement et d'agrégation claires se sont révélées nettement plus stables que les requêtes très ambiguës portant sur des cas limites.
L'une des principales leçons tirées de ces expériences est que la cohérence et l'exactitude ne sont pas synonymes.
Un processus de travail peut permettre de maintenir de manière fiable une méthodologie qui est statistiquement peu solide, présentant des lacunes sur le plan opérationnel ou biaisée.
Dans une expérience de classement, le représentant qui occupait systématiquement la première place disposait également de l'un des plus petits échantillons de l'ensemble de données. Le processus a reproduit le même résultat à chaque fois, mais cela ne rendait pas pour autant la conclusion fiable.
Les workflows permettent de conserver les décisions analytiques. Ils ne vérifient pas si ces décisions sont correctes.
L'intervention humaine reste essentielle :
Le choix des indicateurs doit être évalué avec soin
ces seuils nécessitent une expertise dans le domaine
La logique d'agrégation doit être validée
les cas limites nécessitent un jugement opérationnel
Cela revêt une importance particulière avant que les workflows ne soient déployés dans les systèmes de production qui influencent les décisions commerciales ou les résultats pour les clients.
L'objectif n'est pas simplement la reproductibilité. L'objectif est une analyse reproductible et bien encadrée.
Les exécutions des workflows ont été systématiquement plus rapides dans toutes les expériences.
En l'absence de workflows, l'agent passait du temps à effectuer les tâches suivantes de manière répétitive :
explorer l'ensemble de données
réévaluer les méthodologies
révision des calculs
réévaluer les approches analytiques
générer des chemins d'exécution alternatifs
Chaque étape de raisonnement supplémentaire entraînait davantage d'appels au LLM, une charge d'exécution plus importante et davantage de risques de divergence.
Grâce aux workflows, une grande partie de ce raisonnement exploratoire a été supprimée. Le chemin d'exécution étant déjà défini, le système pouvait se concentrer sur l'exécution de l'analyse plutôt que de la réinventer.
La réduction des détours analytiques a permis d'obtenir :
des chemins d'exécution plus courts
des temps de réponse plus courts
un comportement plus prévisible lors de l'exécution
Les gains de performances n'étaient pas parfaitement déterministes, mais la tendance est restée constante dans toutes les expériences : la réduction du nombre de détours analytiques a permis une exécution plus rapide et plus stable.
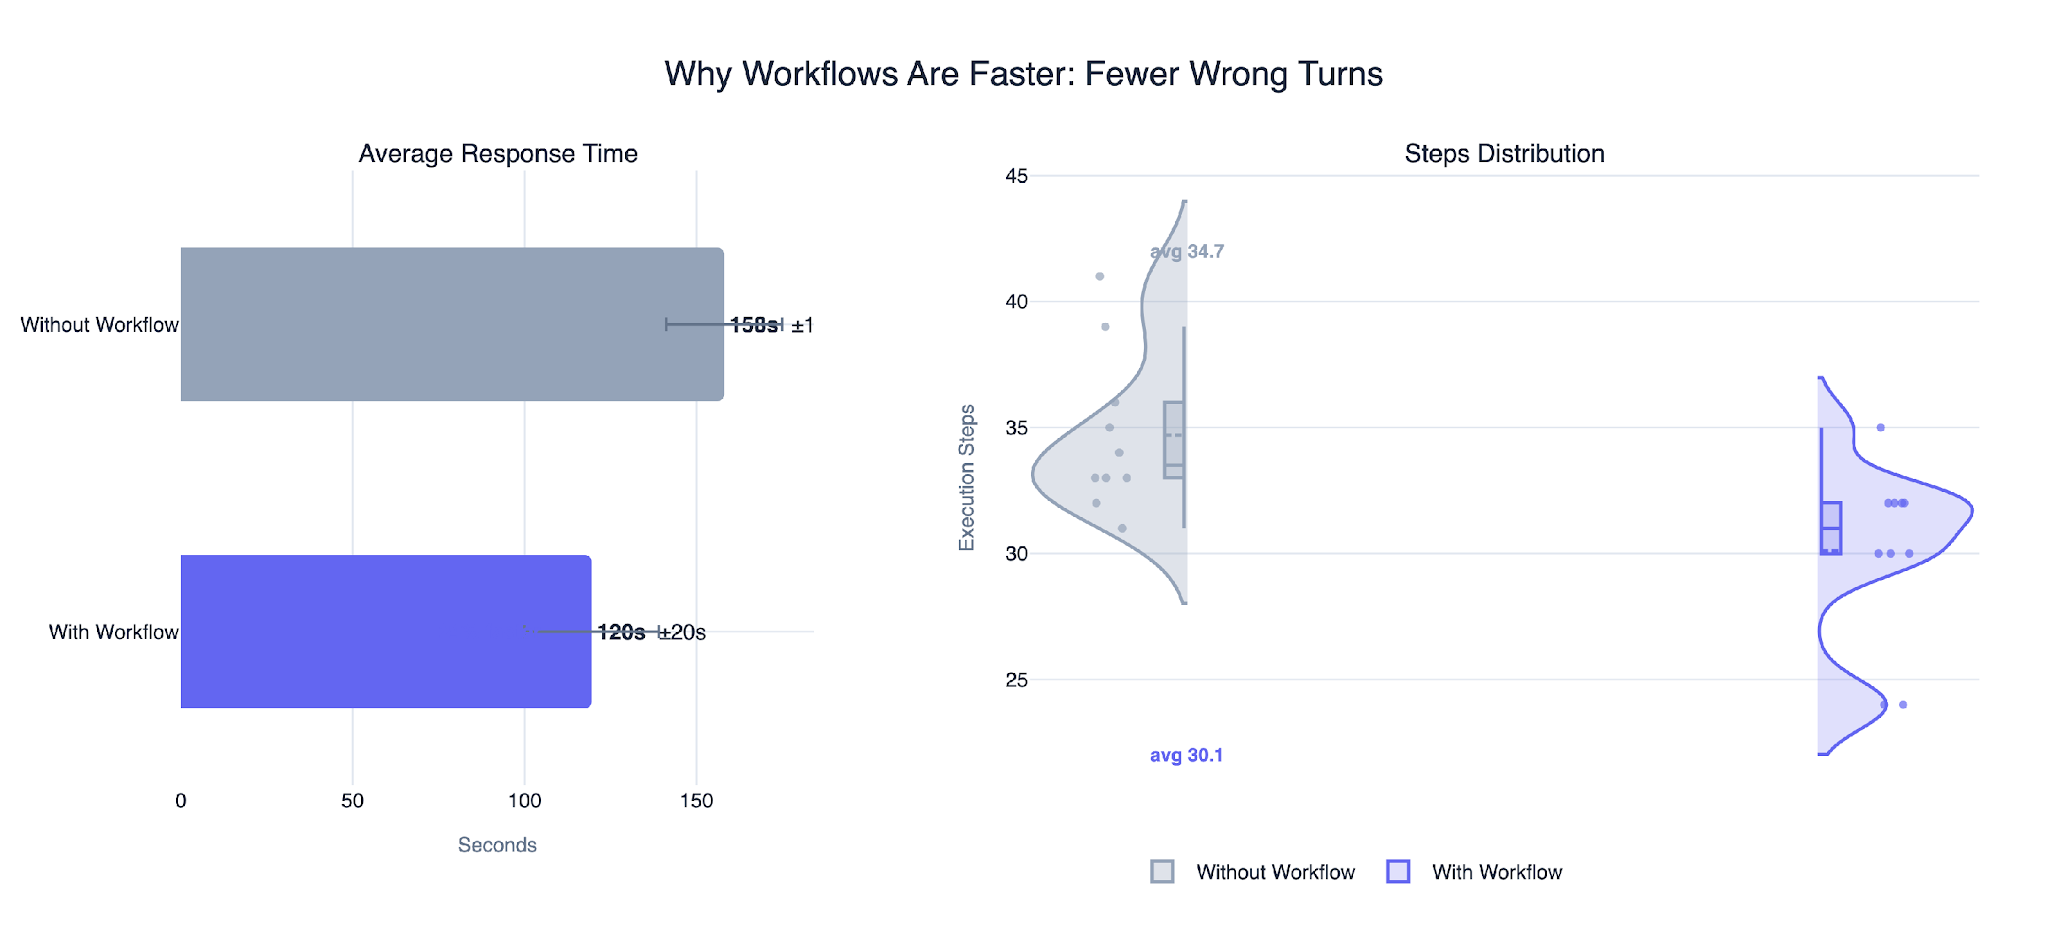 Workflow-constrained executions completed faster and required fewer reasoning steps than fully dynamic agentic executions.
Les expériences ont montré que les flux de travail sont particulièrement utiles dans les systèmes où la cohérence prime sur l'exploration.
Les workflows constituent une solution particulièrement adaptée dans les cas suivants :
Les rapports doivent être reproductibles.
Les résultats alimentent les systèmes en aval ou les tableaux de bord.
La logique analytique doit rester stable dans le temps.
Les résultats font l'objet d'un examen opérationnel ou d'un Audit ultérieur.
Les équipes ont besoin que les classements, les seuils ou les calculs restent cohérents d'une exécution à l'autre.
Cela est particulièrement important pour :
rapports opérationnels
contrôles de conformité
Systèmes d'assurance qualité
détection des anomalies
alertes automatisées
plateformes d'analyse de la clientèle
Dans ces contextes, la reproductibilité prime largement sur la créativité.
Cependant, les workflows ne constituent pas la solution idéale pour tous les cas d'utilisation.
Le raisonnement agentique dynamique reste utile lorsque :
explorer des ensembles de données inconnus
élaborer des hypothèses
proposer d'autres angles d'analyse
expérimenter différentes méthodologies
à la recherche de tendances inattendues
Dans ces situations, la diversité peut en réalité s'avérer utile, car elle permet de mettre en évidence différentes approches et perspectives.
Le principal compromis réside entre flexibilité et cohérence. Les flux de travail limitent délibérément certains aspects du processus de raisonnement afin que le comportement analytique devienne plus prévisible au fil du temps.
Les agents d'IA sont puissants car ils sont capables de raisonner de manière dynamique, de s'adapter au contexte et de générer des approches analytiques à la volée. Mais cette flexibilité s'accompagne également d'une certaine variabilité.
Les quatre expériences ont toutes mis en évidence la même tendance : lorsque la méthodologie analytique était laissée entièrement dynamique, les résultats variaient d'une exécution à l'autre, même lorsque la requête et les données sous-jacentes restaient inchangées.
Les workflows ont permis de réduire cet écart en préservant les décisions critiques qui sous-tendent l'analyse, notamment les indicateurs, les seuils, la logique de regroupement et les chemins d'exécution.
Ils ne rendent pas les systèmes agentiques parfaitement déterministes et ne garantissent pas leur exactitude. L'examen humain, la validation et l'expertise dans le domaine restent essentiels.
Mais lorsque la cohérence, la reproductibilité et la fiabilité opérationnelle sont essentielles, les workflows constituent un moyen pratique de rendre les systèmes agents nettement plus prévisibles dans les environnements de production.
Vous avez une question ou souhaitez partager ce que vous construisez ?
S'abonner à la Bulletin d'information du développeur
Suivez-nous sur X (anciennement Twitter) pour les mises à jour
Regardez les tutoriels sur notre chaîne YouTube
Connectez-vous avec nous sur la page Vonage Developer sur LinkedIn
Aidez-nous à améliorer l'expérience des développeurs en remplissant notre formulaire de commentaires « Voice of the Developer »
Restez connecté et tenez-vous au courant des dernières nouvelles, astuces et événements concernant les développeurs.
Les expériences présentées dans cet article s'appuient sur un workflow « golden run » validé, ainsi que sur des configurations expérimentales, des définitions de métriques et des exemples de mise en œuvre.
Pour les lecteurs souhaitant approfondir la méthodologie, nous avons publié l'ensemble des documents d'accompagnement sur GitHub :
Répertoires de workflows agentiques prévisibles
Le référentiel comprend :
l'ensemble du processus « Golden Run » en sept étapes,
configurations expérimentales,
définitions métriques,
exemples de validation et de gestion des cas limites,
ainsi que les schémas utilisés tout au long de cet article.