Partager:
Nimrod est data scientist chez Vonage ; il possède près de 10 ans d'expérience dans le secteur de l'apprentissage automatique et de l'intelligence artificielle. Physicien de formation, il a travaillé à l'application de l'apprentissage automatique et de l'IA à toute une série de problèmes concrets. Son travail consiste notamment à développer des solutions basées sur les données et à explorer l'utilisation des technologies émergentes en matière d'IA, notamment les grands modèles linguistiques.
La taxe cachée sur les jetons dans les schémas JSON
Les sorties structurées sont désormais l'un des moyens les plus sûrs d'intégrer des modèles linguistiques de grande envergure (LLM) dans des systèmes de production. Vous transmettez un schéma JSON à votre API LLM, et la réponse est garantie de respecter cette structure. Pas d'échecs d'analyse, pas de réponses mal formées, pas de logique de nouvelle tentative.
Les schémas JSON augmentent l'utilisation des jetons d'entrée, car le schéma est inclus dans chaque requête envoyée au modèle. Selon le fournisseur, cette surcharge peut aller de pratiquement négligeable à plus de dix fois la taille initiale de la requête.
Dans cet article, vous découvrirez les mesures effectuées sur plusieurs modèles et apprendrez comment réduire cette surcharge.
Petit guide d'introduction pour ceux qui ne connaissent pas bien la facturation des modèles linguistiques (LLM) : les modèles linguistiques traitent le texte sous forme de « tokens », c'est-à-dire des fragments de mots d'environ 3 à 4 caractères chacun. Vous payez au token, tant pour ce que vous envoyez (tokens d'entrée) que pour ce que vous recevez en retour (tokens de sortie). Lorsqu'un élément ajoute discrètement des tokens à votre appel d'API, cela se répercute directement sur votre facture.
Le Centre d'excellence en IA (CoE) de Vonage a adopté le format de sortie structuré dans l'ensemble de ses pipelines : analyse des sentiments, extraction d'entités et évaluation des interactions clients. L'amélioration de l'expérience des développeurs a été immédiate.
Au cours des tests, nous avons toutefois remarqué un phénomène inattendu. Notre consommation de tokens était systématiquement supérieure à ce que nos prompts auraient dû générer à eux seuls — pas suffisamment pour déclencher une alerte, mais suffisamment pour que cela attire notre attention. Nous faisions passer de courtes requêtes analytiques, d’environ 100 tokens chacune, dans des modèles auxquels étaient associés des schémas JSON. La taille des requêtes était négligeable ; d’où provenaient donc ces tokens supplémentaires ? Nous avons mis en place une expérience pour le découvrir.
La documentation relative à la sortie structurée explique comment l'utiliser, mais ne précise pas son coût. Chaque fournisseur dispose d'une page intitulée « Sortie structurée » qui détaille les paramètres de l'API. Aucun d'entre eux n'explique comment le nombre de jetons est affecté lorsque vous joignez un schéma.
Nous voulions répondre à une question simple : lorsque l'on transmet un schéma JSON à un modèle de langage de grande envergure (LLM), combien de tokens d'entrée supplémentaires cela ajoute-t-il réellement ?
La configuration était volontairement minimaliste. Même invite, mêmes instructions système, même température. La seule variable était la présence ou non d'un schéma, ainsi que le degré de complexité de ce dernier.
Nous avons testé cinq schémas, allant des plus simples aux plus sophistiqués, adaptés à un environnement de production. Le schéma minimal ne comportait qu’un seul champ (88 caractères au format JSON) :
{
  "type": "object",
  "properties": {
    "answer": { "type": "string" }
  },
  "required": ["answer"]
} À partir de là, nous avons augmenté le niveau de complexité :
Simple - trois champs avec une contrainte d'énumération (237 caractères)
Moyen - un objet imbriqué contenant des tableaux (358 caractères)
Complexe - tableaux d'objets avec des énumérations (555 caractères)
Très complexe - imbrication profonde, plusieurs tableaux, booléens, énumérations (1 730 caractères)
La consigne elle-même consistait en un bref échange avec le service client, qui a nécessité environ 99 tokens sur le tokeniseur de Gemini et 121 sur celui de Claude. Les différents tokeniseurs segmentent le même texte de manière différente, ce qui explique l'écart de référence entre les fournisseurs. Nous avons délibérément choisi une consigne courte afin d'évaluer la surcharge de manière isolée, sans qu'elle soit noyée dans un contexte trop long.
Nous l'avons testé sur trois modèles : Gemini 2.5 Flash, Gemini 3.5 Flash et Claude Haiku 4.5.
Le graphique ci-dessous présente le nombre total de jetons d'entrée déclarés par chaque modèle pour les cinq niveaux de complexité de schéma. Les barres grises de référence correspondent à la même instruction envoyée sans schéma associé.
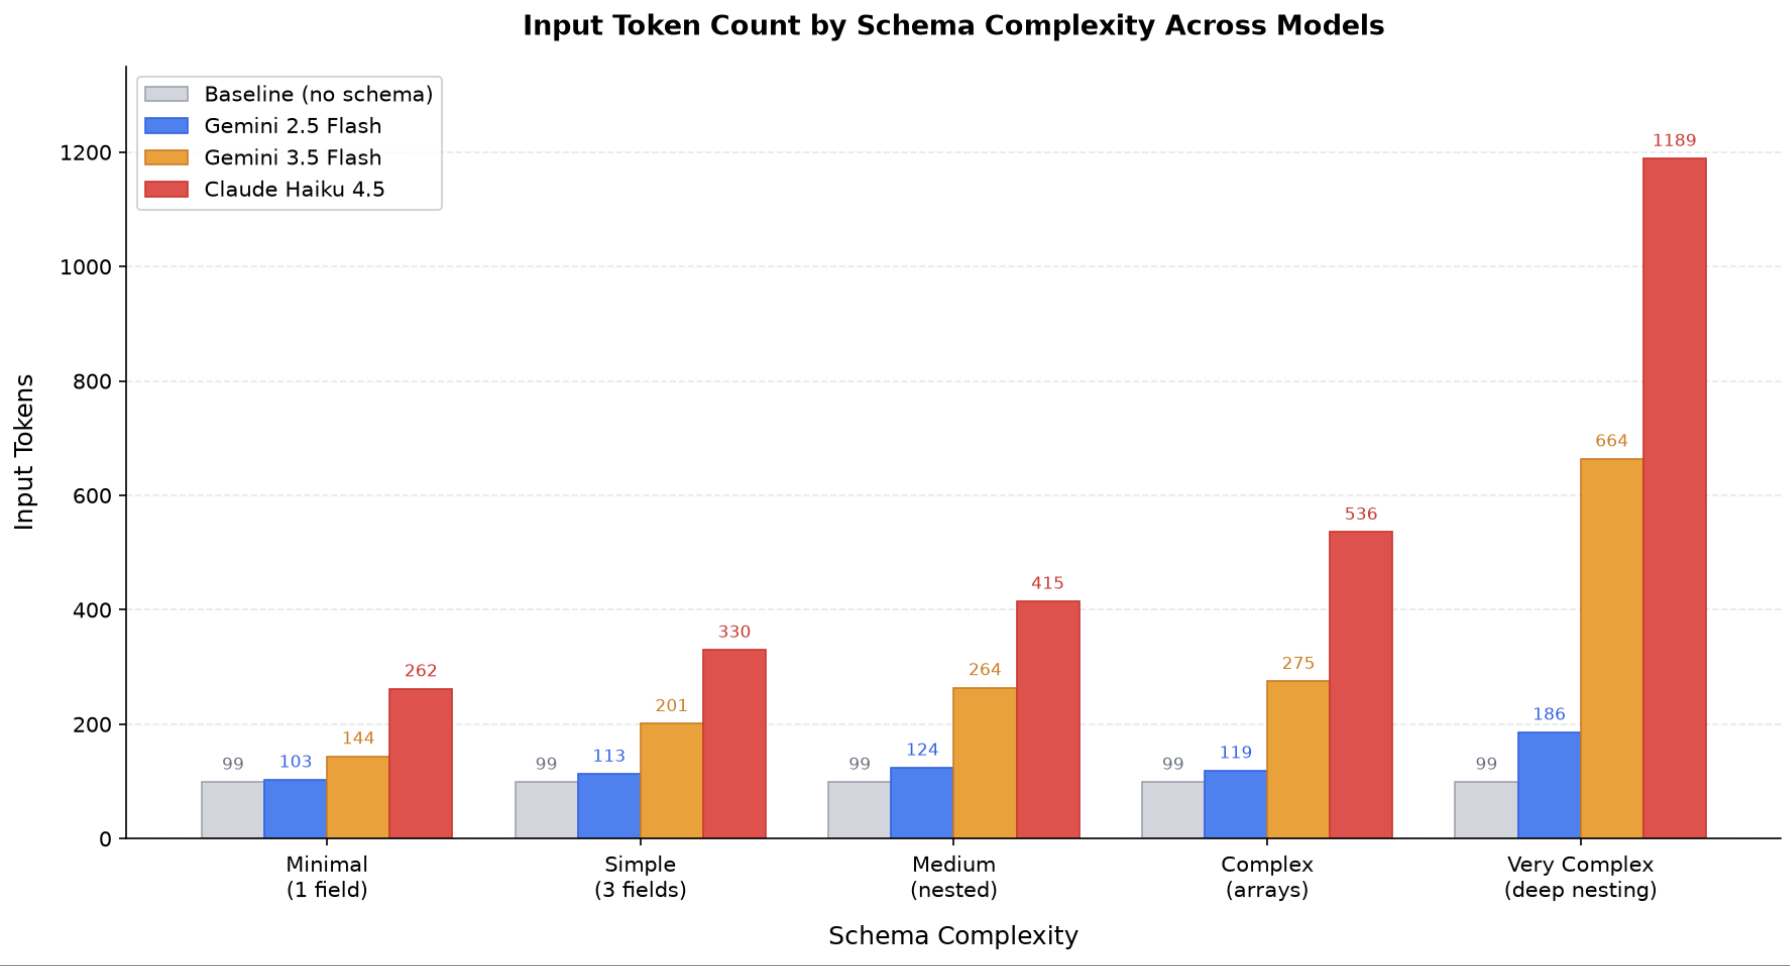 Les résultats révèlent une tendance claire. Comme on pouvait s'y attendre, l'augmentation de la complexité entraîne une hausse de la consommation de tokens pour les trois modèles. Mais l'un d'entre eux se démarque nettement : Gemini 2.5 Flash reste proche de la référence tout au long du test. Pour le schéma profondément imbriqué, Gemini 2.5 Flash utilise 186 tokens, contre 1 189 pour Claude Haiku 4.5.
La comptabilité des jetons varie légèrement d'un fournisseur à l'autre ; ces chiffres reflètent donc les jetons de facturation déclarés plutôt que les détails de mise en œuvre interne.
Pris individuellement, les jetons ne coûtent pas cher. Mais le coût varie en fonction de votre cas d'utilisation.
Si vous effectuez une sortie structurée sur des documents volumineux — disons, plus de 5 000 tokens en entrée —, la surcharge est négligeable. Quelques centaines de tokens supplémentaires en plus de 5 000, c'est une erreur d'arrondi.
Mais la plupart des appels de sortie structurée en production ne s'inscrivent pas dans un contexte à long terme. Il s'agit de tâches analytiques courtes :
Classez ce message client (ton, intention, urgence)
Extraire les entités de cette phrase
Évaluez cette interaction selon cinq critères
Transférez ce ticket au service concerné
Ces requêtes comptent généralement entre 50 et 500 jetons. À cette échelle, les frais généraux deviennent le principal facteur pesant sur votre facture de jetons d'entrée.
Prenons l'exemple d'un schéma de complexité moyenne sur Claude Haiku 4.5 avec une consigne de 100 tokens :
Sans schéma : 121 tokens d'entrée
Avec le schéma : 415 tokens d'entrée
Frais généraux : 71 % du montant total de vos factures d'approvisionnement
Vous payez près de 3,5 fois plus en jetons d'entrée que ne le justifie votre contenu réel. Si l'on extrapole ce chiffre à des millions d'appels API par mois, cela devient un facteur de coût non négligeable.
C'est là que les choses deviennent intéressantes pour tous ceux qui évaluent des modèles destinés à des charges de travail de production.
Pour une charge utile de 100 jetons avec un schéma moyen :
Modèle | Contribution efficace | Prix/M jetons | Coût pour 1 million d'appels |
Gemini 2.5 Flash | 124 jetons | 0,30 $ | 37,20 $ |
Gemini 3.5 Flash | 264 jetons | 1,50 $ | 396,00 $ |
Claude Haiku 4.5 | 415 jetons | 0,80 $ | 332,00 $ |
Prix en vigueur en juillet 2026
Gemini 2.5 Flash est environ neuf fois moins cher que Claude Haiku et onze fois moins cher que Gemini 3.5 Flash pour ce cas d'utilisation spécifique. Cela ne tient pas uniquement au prix de base, mais aussi à la manière dont chaque modèle gère le schéma en interne.
Les rapports de prix de base (Haiku coûte 2,7 fois plus cher que 2,5 Flash par jeton) sont amplifiés par les frais généraux, ce qui se traduit par des écarts de coût effectifs bien plus importants.
La surcharge correspond à un coût fixe par appel. À mesure que la charge utile d'entrée augmente, elle diminue progressivement :
Avec 500 tokens (un message client court avec contexte), le schéma « medium » augmente la taille de 37 % sur Haiku
À 2 000 jetons (transcription complète d'une conversation) : baisse à 13 %
Pour 5 000 tokens (un résumé de document ou un extrait contextuel RAG) : moins de 6 %
À 10 000 tokens (un document long ou un historique à plusieurs tours) : environ 3 %
Si votre charge de travail consiste à résumer des documents, à appliquer l'algorithme RAG à des extraits de texte ou à analyser des transcriptions de conversations complètes, la surcharge est véritablement négligeable. Cela concerne principalement les charges de travail à haut volume et à prompts courts, telles que la classification, l'acheminement et l'extraction d'entités.
Lorsque vous transmettez un schéma JSON via l'API, les modèles le traitent globalement de deux manières :
Encodage compact - le schéma est traité efficacement, éventuellement sous forme de jetons spéciaux ou d'instructions compressées. Gemini 2.5 Flash semble encoder les schémas de cette manière. La surcharge est minime et augmente lentement avec la taille du schéma.
Développement détaillé - le schéma est converti en instructions en langage naturel qui énoncent explicitement chaque contrainte. C'est ce que semblent faire Gemini 3.5 Flash et Claude Haiku, d'après le nombre de tokens, et cela explique pourquoi leur surcoût évolue de manière à peu près linéaire avec le nombre de caractères du schéma.
L'approche détaillée garantit sans doute un respect plus fiable du schéma pour les structures complexes, mais elle entraîne un coût en jetons qu'aucun fournisseur ne mentionne.
Voici comment le réduire :
Veillez à ce que les schémas restent succincts. Supprimez les champs que vous n'utilisez pas dans votre code en aval. Aplatissez les structures imbriquées lorsque la hiérarchie n'est pas nécessaire d'un point de vue sémantique. Placez les descriptions et les exemples dans votre invite, et non dans la définition du schéma elle-même. Un schéma réduit de 1 730 caractères à 555 vous fait économiser environ 650 tokens par appel sur Claude.
Sur Claude, la surcharge liée au schéma varie entre 0,6 et 1,6 jetons supplémentaires par caractère du JSON du schéma, les schémas plus petits entraînant proportionnellement une surcharge plus importante. Sur Gemini 3.5 Flash, elle est plus faible (environ 0,3 à 0,5 jeton par caractère), mais reste significative à grande échelle.Adaptez le modèle à la structure de la charge de travail. Si votre charge de travail en production consiste principalement en des sorties structurées à partir de prompts courts (moins de 500 tokens de contenu réel), la surcharge doit faire partie de vos critères de sélection de modèle. Si vos entrées sont longues (plus de 2 000 tokens), la surcharge est négligeable. Privilégiez alors la qualité et la latence.
Envisagez de ne pas utiliser de schéma pour les cas simples. Pour une étiquette de classification unique ou un indicateur booléen, une invite bien conçue demandant directement du JSON n'entraîne aucun surcoût. Vous sacrifiez un peu de fiabilité au profit d'économies, ce qui en vaut la peine lorsque la structure est simple.
Regroupez les opérations par lots lorsque cela est possible. Les frais généraux correspondent à un coût fixe par appel. Traiter 10 éléments en un seul appel permet de ne payer ces frais qu'une seule fois au lieu de dix.
Mesurez-le. Effectuez le même appel avec et sans le schéma. La différence entre le nombre de tokens d'entrée correspond à votre coût caché. Multipliez ce chiffre par le volume d'appels et le prix par token. Ce chiffre doit être intégré à votre modèle de coûts.
La surcharge liée au schéma est un coût qui n'apparaît pas comme une ligne distincte sur votre facture. Pour les équipes qui effectuent des millions d'appels générant des résultats structurés à partir de prompts courts, elle peut représenter la majeure partie de vos dépenses en jetons d'entrée. Mesurer cette surcharge liée au schéma et en tenir compte lors de la sélection du modèle constitue la première étape pour réduire les coûts superflus liés à l'IA.
Les expériences décrites dans cet article ont utilisé des consignes identiques pour tous les modèles et toutes les conditions :
Les modèles Gemini ont été testés via l'API REST de Vertex AI (us-central1 pour 2,5 Flash, global pour 3,5 Flash)
Claude Haiku 4.5 a été testé via AWS Bedrock
La température a été réglée sur 0,0 pour toutes les séries d'essais.
Cinq niveaux de complexité de schéma ont été testés, chacun étant exécuté à la fois en mode de contrôle (sans schéma) et en mode avec schéma.
Les chiffres relatifs aux jetons sont ceux communiqués par l'API d'utilisation de chaque fournisseur.
Vous avez une question ou souhaitez partager ce que vous construisez ?
S'abonner à la Bulletin d'information du développeur
Suivez-nous sur X (anciennement Twitter) pour les mises à jour
Regardez les tutoriels sur notre chaîne YouTube
Connectez-vous avec nous sur la page Vonage Developer sur LinkedIn
Aidez-nous à améliorer l'expérience des développeurs en remplissant notre formulaire de commentaires « Voice of the Developer »
Restez connecté et tenez-vous au courant des dernières nouvelles, astuces et événements concernant les développeurs.
Partager:
Nimrod est data scientist chez Vonage ; il possède près de 10 ans d'expérience dans le secteur de l'apprentissage automatique et de l'intelligence artificielle. Physicien de formation, il a travaillé à l'application de l'apprentissage automatique et de l'IA à toute une série de problèmes concrets. Son travail consiste notamment à développer des solutions basées sur les données et à explorer l'utilisation des technologies émergentes en matière d'IA, notamment les grands modèles linguistiques.