Compartir:
Nimrod es científico de datos en Vonage y cuenta con casi 10 años de experiencia en el sector del aprendizaje automático y la inteligencia artificial. Es físico de formación y ha trabajado en la aplicación del aprendizaje automático y la IA a diversos problemas prácticos. Su trabajo incluye el desarrollo de soluciones basadas en datos y la exploración del uso de tecnologías emergentes de IA, incluidos los modelos de lenguaje a gran escala.
El impuesto oculto sobre los tokens en los esquemas JSON
La salida estructurada se ha convertido en una de las formas más seguras de integrar los modelos de lenguaje a gran escala (LLM) en los sistemas de producción. Al realizar una llamada a la API del LLM, se le pasa un esquema JSON y se garantiza que la respuesta se ajustará a esa estructura. Sin errores de análisis, sin respuestas mal formadas y sin necesidad de lógica de reintentos.
Los esquemas JSON aumentan el uso de tokens de entrada, ya que el esquema se incluye en cada solicitud enviada al modelo. Dependiendo del proveedor, esta sobrecarga puede variar desde un valor casi insignificante hasta más de diez veces el tamaño original del prompt.
En este artículo, podrás consultar las mediciones de varios modelos y aprenderás a reducir esa sobrecarga.
Una breve introducción para quienes no estén muy familiarizados con la facturación de los modelos de lenguaje (LLM): los modelos de lenguaje procesan el texto en forma de tokens, es decir, fragmentos de palabras de unos 3 o 4 caracteres cada uno. Se paga por token, tanto por lo que se envía (tokens de entrada) como por lo que se recibe (tokens de salida). Cuando algo añade tokens de forma silenciosa a tu llamada a la API, se añade directamente a tu factura.
El Centro de Excelencia en IA (CoE) de Vonage adoptó la salida estructurada en todos nuestros procesos: análisis de opiniones, extracción de entidades y puntuación de las interacciones con los clientes. La mejora en la experiencia de los desarrolladores fue inmediata.
Sin embargo, durante las pruebas, observamos un patrón inesperado. Nuestro consumo de tokens era sistemáticamente superior al que deberían haber generado nuestras instrucciones por sí solas; no lo suficiente como para activar una alerta, pero sí lo suficiente como para llamarnos la atención. Estábamos procesando indicaciones analíticas breves, de unos 100 tokens cada una, a través de modelos con esquemas JSON adjuntos. El tamaño de las indicaciones era insignificante, así que, ¿de dónde procedían los tokens adicionales? Montamos un experimento para averiguarlo.
La documentación sobre la salida estructurada explica cómo utilizarla, pero no a cuánto cuesta. Todos los proveedores tienen una página titulada «Salida estructurada» en la que se explican los parámetros de la API. Ninguno de ellos aclara qué ocurre con tu recuento de tokens cuando adjuntas un esquema.
Queríamos responder a una pregunta muy sencilla: cuando se envía un esquema JSON a un modelo de lenguaje grande (LLM), ¿cuántos tokens de entrada adicionales se añaden realmente?
La configuración fue deliberadamente mínima. La misma indicación, las mismas instrucciones del sistema, la misma temperatura. La única variable era si se había adjuntado un esquema y cuál era su grado de complejidad.
Hemos probado cinco esquemas que van desde los más sencillos hasta los aptos para producción. El El consistía en un único campo (88 caracteres de JSON):
{
  "type": "object",
  "properties": {
    "answer": { "type": "string" }
  },
  "required": ["answer"]
} A partir de ahí, fuimos aumentando el nivel de complejidad:
Sencillo - tres campos con una restricción de enumeración (237 caracteres)
Medio - un objeto anidado con matrices (358 caracteres)
Complejo - matrices de objetos con enumeraciones (555 caracteres)
Muy complejo - anidamiento profundo, múltiples matrices, valores booleanos, enumeraciones (1.730 caracteres)
La indicación en sí era una breve interacción de atención al cliente que consumía unos 99 tokens en el tokenizador de Gemini y 121 en el de Claude. Los distintos tokenizadores dividen el mismo texto de forma diferente, lo que explica la diferencia de referencia entre los proveedores. Redujimos deliberadamente el tamaño de la indicación porque queríamos observar la sobrecarga de forma aislada, sin que quedara oculta bajo un contexto extenso.
Lo probamos con tres modelos: Gemini 2.5 Flash, Gemini 3.5 Flash y Claude Haiku 4.5.
El gráfico siguiente muestra el total de tokens de entrada comunicados por cada modelo en los cinco niveles de complejidad del esquema. Las barras grises de referencia representan la misma indicación enviada sin ningún esquema adjunto.
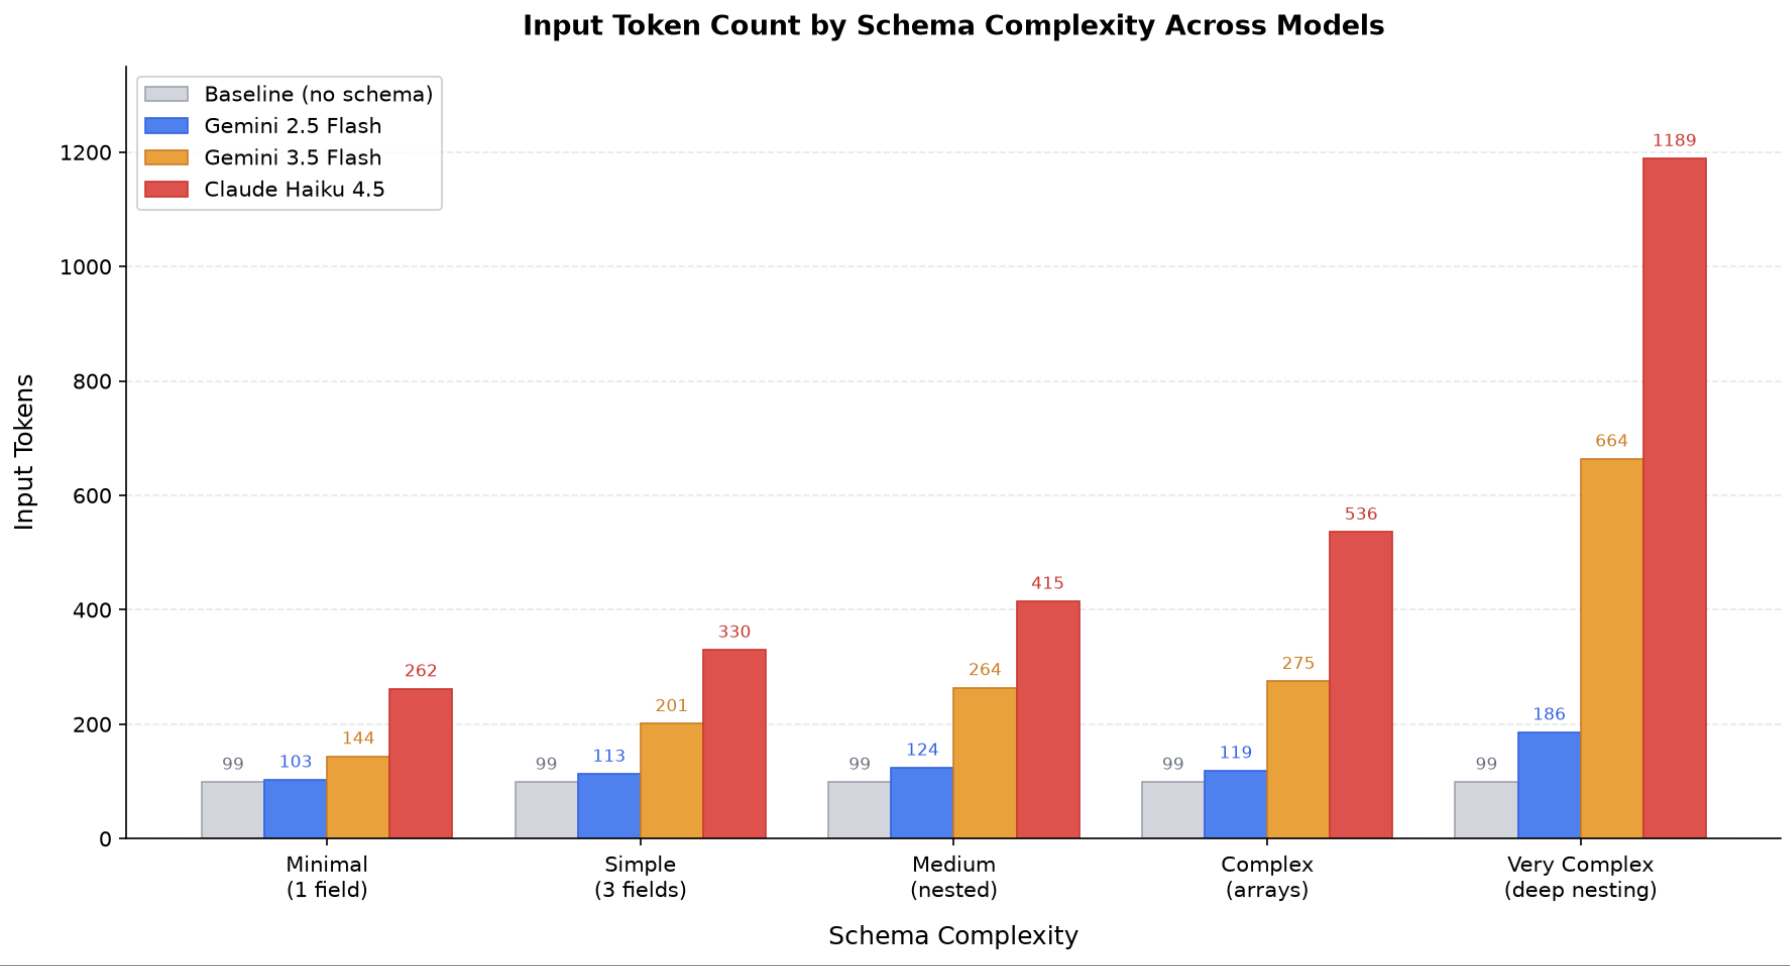 Los resultados muestran una tendencia clara. Tal y como se esperaba, el aumento de la complejidad conlleva un mayor consumo de tokens en los tres modelos. Sin embargo, hay uno que destaca claramente: Gemini 2.5 Flash se mantiene cercano al modelo de referencia en todo momento. En el caso del esquema profundamente anidado, Gemini 2.5 Flash utiliza 186 tokens, frente a los 1.189 de Claude Haiku 4.5.
La contabilidad de tokens varía ligeramente según el proveedor, por lo que estas cifras reflejan los tokens de facturación declarados y no los detalles internos de la implementación.
Por separado, los tokens son baratos. Pero el panorama de los costes varía en función del uso que se les dé.
Si estás procesando salida estructurada con documentos largos —por ejemplo, entradas de más de 5.000 tokens—, la sobrecarga es insignificante. Unos pocos cientos de tokens adicionales sobre los 5.000 son un error de redondeo.
Sin embargo, la mayoría de las llamadas de salida estructurada en producción no tienen un contexto extenso. Se trata de tareas analíticas breves:
Clasifica este mensaje de un cliente (sentimiento, intención, urgencia)
Extrae las entidades de esta frase
Evalúa esta interacción en cinco aspectos
Deriva este ticket al departamento correspondiente
Estas solicitudes suelen tener entre 50 y 500 tokens. A esa escala, los gastos generales se convierten en el factor que más influye en el coste total de los tokens de entrada.
Consideremos un esquema de complejidad media en Claude Haiku 4.5 con una indicación de 100 tokens:
Sin esquema: 121 tokens de entrada
Con el esquema: 415 tokens de entrada
Gastos generales: el 71 % del importe total de tus gastos de insumos
Estás pagando casi 3,5 veces más en tokens de entrada de lo que justifica tu contenido real. Si lo extrapolamos a millones de llamadas a la API al mes, esto se convierte en un factor de coste significativo.
Aquí es donde la cosa se pone interesante para cualquiera que esté evaluando modelos para cargas de trabajo de producción.
Con una carga útil de 100 tokens y un esquema medio:
Modelo | Aportación eficaz | Precio por M tokens | Coste por cada millón de llamadas |
Gemini 2.5 Flash | 124 fichas | 0,30 $ | 37,20 $ |
Gemini 3.5 Flash | 264 fichas | 1,50 $ | 396,00 $ |
Claude Haiku 4.5 | 415 fichas | 0,80 $ | 332,00 $ |
Precios a fecha de julio de 2026
Gemini 2.5 Flash es aproximadamente nueve veces más barato que Claude Haiku y once veces más barato que Gemini 3.5 Flash para este caso de uso concreto. No solo por el precio base, sino por la forma en que cada modelo gestiona el esquema internamente.
Las relaciones de precios base (Haiku es 2,7 veces más caro que 2,5 Flash por token) se ven amplificadas por los gastos generales, lo que da lugar a diferencias de coste efectivas mucho mayores.
La sobrecarga es un coste fijo por llamada. A medida que aumenta la carga útil de entrada, va disminuyendo:
Con 500 tokens (un mensaje breve del cliente con contexto), el esquema «medium» añade un 37 % en Haiku.
A partir de 2.000 tokens (una transcripción completa de una conversación): se reduce al 13 %
Con 5.000 tokens (un resumen de documento o un fragmento de contexto RAG): menos del 6 %
A partir de 10 000 tokens (un documento extenso o un historial de varias rondas): aproximadamente el 3 %
Si tu carga de trabajo consiste en resumir documentos, aplicar el método RAG a fragmentos extraídos o analizar transcripciones completas de conversaciones, la sobrecarga es realmente insignificante. Esto supone principalmente un problema para cargas de trabajo con gran volumen y consignas breves, como la clasificación, el enrutamiento y la extracción de entidades.
Cuando se envía un esquema JSON a través de la API, los modelos lo gestionan, en términos generales, de dos maneras:
Codificación compacta - el esquema se procesa de forma eficiente, posiblemente como tokens especiales o como una instrucción comprimida. Gemini 2.5 Flash parece codificar los esquemas de esta manera. La sobrecarga es mínima y varía ligeramente en función del tamaño del esquema.
Expansión detallada - el esquema se convierte en instrucciones en lenguaje natural que detallan explícitamente cada restricción. Esto es lo que sugieren los recuentos de tokens que están haciendo Gemini 3.5 Flash y Claude Haiku, y explica por qué su sobrecarga varía de forma más o menos lineal con el número de caracteres del esquema.
Es probable que el enfoque detallado garantice un cumplimiento más fiable del esquema en el caso de estructuras complejas, pero conlleva un coste en términos de tokens que ningún proveedor documenta.
A continuación te explicamos cómo reducirlo:
Mantén los esquemas lo más sencillos posible. Elimina los campos que no utilices en tu código posterior. Simplifica las estructuras anidadas cuando la jerarquía no sea semánticamente necesaria. Incluye descripciones y ejemplos en tu prompt, no en la propia definición del esquema. Un esquema reducido de 1.730 caracteres a 555 te ahorra aproximadamente 650 tokens por llamada en Claude.
En Claude, la sobrecarga del esquema oscila entre 0,6 y 1,6 tokens adicionales por carácter del JSON del esquema, y los esquemas más pequeños conllevan proporcionalmente una mayor sobrecarga. En Gemini 3.5 Flash es menor —aproximadamente entre 0,3 y 0,5 tokens por carácter—, pero sigue sumando cuando el volumen es elevado.Adapta el modelo a la estructura de la carga de trabajo. Si tu carga de trabajo en producción consiste principalmente en salidas estructuradas con prompts cortos (menos de 500 tokens de contenido real), la sobrecarga debería formar parte de tus criterios de selección del modelo. Si tus entradas son largas (más de 2.000 tokens), la sobrecarga es insignificante. En ese caso, elige en función de la calidad y la latencia.
Plantéate prescindir del esquema en los casos sencillos. En el caso de una única etiqueta de clasificación o un indicador booleano, una solicitud bien redactada que pida directamente JSON no supone ningún coste adicional. Se sacrifica algo de fiabilidad a cambio de un ahorro de costes, lo cual merece la pena cuando la estructura es sencilla.
Agrupa las tareas siempre que sea posible. Los gastos generales son un coste fijo por llamada. Al procesar 10 elementos en una sola llamada, se pagan una sola vez en lugar de diez veces.
Mídelo. Ejecuta la misma llamada con y sin el esquema. La diferencia en los tokens de entrada es tu coste oculto. Multiplícalo por el volumen de llamadas y el precio por token. Esa cifra debe incluirse en tu modelo de costes.
La sobrecarga del esquema es un coste que no aparece como una partida independiente en la factura. Para los equipos que realizan millones de llamadas con salida estructurada y prompts breves, puede suponer la mayor parte del gasto en tokens de entrada. Medir la sobrecarga del esquema y tenerla en cuenta durante la selección del modelo es el primer paso para reducir los costes innecesarios de la IA.
En los experimentos descritos en este artículo se utilizaron indicaciones idénticas en todos los modelos y condiciones:
Los modelos de Gemini se probaron mediante la API REST de Vertex AI (us-central1 para 2.5 Flash, global para 3.5 Flash)
Claude Haiku 4.5 se probó a través de AWS Bedrock
La temperatura se fijó en 0,0 en todas las series.
Se probaron cinco niveles de complejidad del esquema, cada uno de ellos ejecutado tanto en modo de control (sin esquema) como en modo con esquema.
Los recuentos de tokens son los que indican las API de uso de cada proveedor.
¿Tiene alguna pregunta o quiere compartir lo que está construyendo?
Suscríbase al Boletín para desarrolladores
Síguenos en X (antes Twitter) para estar al día
Ver tutoriales en nuestro canal de YouTube
Conéctese con nosotros en la página Vonage Developer en LinkedIn
Ayúdanos a mejorar nuestra experiencia como desarrolladores rellenando nuestro cuestionario «La voz del desarrollador»
Mantente conectado y entérate de las últimas noticias, consejos y eventos para desarrolladores.
Compartir:
Nimrod es científico de datos en Vonage y cuenta con casi 10 años de experiencia en el sector del aprendizaje automático y la inteligencia artificial. Es físico de formación y ha trabajado en la aplicación del aprendizaje automático y la IA a diversos problemas prácticos. Su trabajo incluye el desarrollo de soluciones basadas en datos y la exploración del uso de tecnologías emergentes de IA, incluidos los modelos de lenguaje a gran escala.