Compartir:
Alberto is a Senior Software Engineer at Vonage, with deep experience in the Video product across the Ecosystem, Platform Quality, and Video API teams. He thrives at the intersection of front-end craft and back-end logic. Having lived in Barcelona, Sydney, and San Francisco, he brings over a decade of building and shaping the visible side of real-time platforms and a growing focus on agentic AI product development.
Mejora la fiabilidad de tu aplicación de vídeo con la Video API de Vonage
Tiempo de lectura: 13 minutos
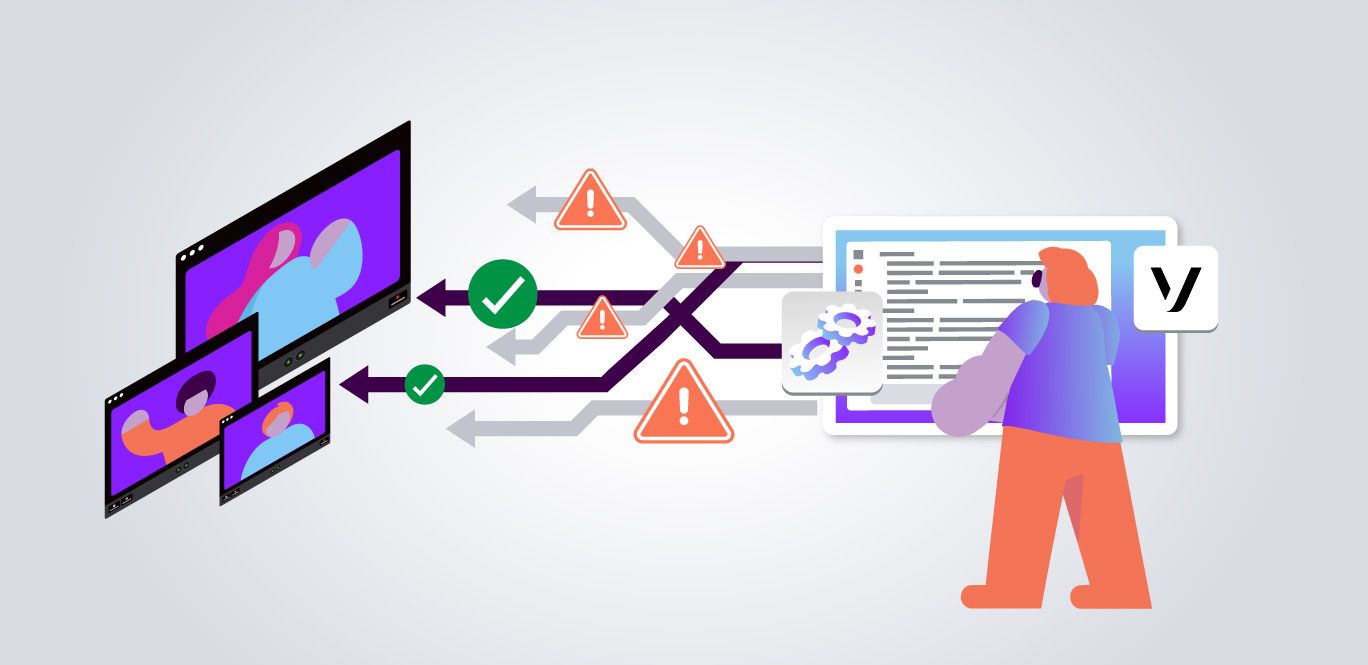
Las interrupciones en la red, los cambios de dispositivo y los fallos en la negociación de medios pueden afectar a cualquier aplicación de video en tiempo real. Una aplicación fiable debe considerar estas situaciones como fallos previsibles y contar con una estrategia de recuperación clara para cada una de ellas.
Este artículo aborda patrones prácticos de reintento y recuperación para el SDK web de la Video API de Vonage. Aprenderás a gestionar los errores al conectarte a una sesión, publicar contenido multimedia, suscribirte a transmisiones y recuperarte de problemas de captación de audio.
El principio fundamental que rige todo el proceso es sencillo: reintentar solo cuando sea seguro hacerlo, liberar recursos cuando sea necesario y evitar que se ejecuten varios intentos de recuperación al mismo tiempo.
Un intento de conexión puede fallar debido a problemas temporales de red o de señalización. Cuando tu aplicación decida volver a intentar establecer una conexión, asegúrate primero de que se haya liberado el recurso del intento de conexión anterior.
Llama session.disconnect() antes de iniciar otro session.connect() intento. Esto garantiza que tu aplicación no siga reintentando con un estado de sesión obsoleto.
En lugar de integrar la lógica de reintento directamente en cada operación de la API, puedes utilizar un ayudante de reintento reutilizable.
const delay = (ms) =>
  new Promise((resolve) => setTimeout(resolve, ms));

async function retryOperation({
  operation,
  shouldRetry,
  maxAttempts = 3,
  getDelay,
}) {
  let lastError;

  for (let attempt = 1; attempt <= maxAttempts; attempt += 1) {
    try {
      return await operation(attempt);
    } catch (error) {
      lastError = error;

      const isLastAttempt = attempt === maxAttempts;

      if (isLastAttempt || !shouldRetry(error)) {
        throw error;
      }

      await delay(getDelay(attempt));
    }
  }

  throw lastError;
} La shouldRetry función decide si es seguro volver a intentar la operación tras un error. Devuelve «true» únicamente para los errores que tu aplicación haya identificado como temporales o recuperables. La getDelay función controla cuánto tiempo hay que esperar antes de cada nuevo intento, por lo que puedes ajustar el intervalo entre reintentos sin modificar la lógica de reintento en sí. El maxAttempts valor controla el número total de intentos.
Este enfoque devuelve un resultado satisfactorio tan pronto como una operación se realiza con éxito y deja de reintentar la operación cuando no es seguro volver a intentarla debido a un error, o cuando se alcanza el número máximo de intentos.
A continuación, puedes utilizar el helper para gestionar los intentos de conexión:
function connectSession(session, token) {
  return new Promise((resolve, reject) => {
    session.connect(token, (error) => {
      if (error) {
        reject(error);
        return;
      }

      resolve();
    });
  });
}

async function connectWithRetry(session, token) {
  return retryOperation({
    operation: async () => {
      await session.disconnect();
      await connectSession(session, token);
    },
    shouldRetry: () => true,
    maxAttempts: 3,
    getDelay: (attempt) => 3000 * attempt,
  });
} En este ejemplo se utilizan un máximo de tres intentos con retroceso lineal. Los retrasos son:
3 segundos antes del segundo intento
6 segundos antes del tercer intento
Si tu aplicación requiere una política de recuperación diferente, haz que la configuración de los reintentos sea configurable, en lugar de modificar la propia implementación de los reintentos.
Ten en cuenta que el número de intentos y el tiempo entre ellos son meras recomendaciones. Siempre puedes ajustarlos para obtener el rendimiento esperado en tu sistema.
Comprender los reintentos a nivel de SDK y de aplicación
Es posible que el SDK ya lleve a cabo una recuperación interna durante algunas fases de la conexión. Por lo tanto, la lógica de reintento a nivel de aplicación debe considerarse como una capa de recuperación adicional.
Antes de basarte en un comportamiento de reintento concreto, comprueba el comportamiento actual del SDK en la documentación correspondiente de la Video API de Vonage.
La publicación de contenidos implica varias etapas. Distinguir estas etapas te ayuda a decidir si tu aplicación debe volver a intentarlo, solicitar una acción por parte del usuario o volver a crear el editor.
Un flujo de trabajo editorial puede incluir dos operaciones distintas:
OT.initPublisher()inicializa el acceso a los dispositivos multimedia y crea un editor.
session.publish(publisher)publica ese contenido multimedia en la sesión.
Los problemas que surgen durante la inicialización pueden requerir una estrategia de recuperación diferente a la de los problemas que se producen al publicar un editor ya inicializado.
Por ejemplo, un problema relacionado con los permisos de la cámara suele requerir la intervención del usuario. Un fallo temporal de la red puede ser motivo para volver a intentarlo.
Evita tratar todos los errores de publicación de la misma manera.
Los errores de publicación pueden deberse a diferentes causas. Algunos pueden deberse a condiciones temporales de la red o de la negociación de medios, mientras que otros requieren una acción por parte del usuario o cambios en la aplicación.
Los siguientes errores son candidatos a un nuevo intento:
Error | Descripción |
OT_TIMEOUT (1500) | Se ha agotado el tiempo de espera de la negociación ICE/SDP |
OT_ICE_FLUJO DE TRABAJO_FALLO | Error en el flujo de trabajo de ICE |
OT_CREATE_PEER_CONNECTION_FAILED | Error al establecer la conexión entre pares |
OT_MEDIA_ERR_ABORTED | Se ha cancelado la operación con el soporte |
OT_MEDIA_ERR_NETWORK | Error en la red multimedia |
OT_MEDIA_ERR_DECODE | Error de decodificación de medios |
OT_MEDIA_ERR_SRC_NOT_SUPPORTED | El formato multimedia no es compatible |
OT_SET_REMOTE_DESCRIPTION_FAILED | Error en la descripción del mando a distancia SDP |
OT_RESPUESTA_INESPERADA_DEL_SERVIDOR | Respuesta inesperada del servidor que puede ser temporal |
Los errores que requieran una acción por parte del usuario o la recuperación de las aplicaciones no deben reintentarse automáticamente:
Error | Medida recomendada |
OT_NO_CONECTADO | Asegúrate de que la sesión esté completamente conectada antes de publicar |
OT_PERMISIO_DENEGADO | Pide al usuario que conceda permiso para acceder a la cámara o al micrófono |
Utiliza una lista explícita de los errores que tu aplicación considera que se pueden volver a intentar:
const RETRYABLE_PUBLISH_ERRORS = new Set([
  'OT_TIMEOUT',
  'OT_ICE_WORKFLOW_FAILED',
  'OT_CREATE_PEER_CONNECTION_FAILED',
  'OT_MEDIA_ERR_ABORTED',
  'OT_MEDIA_ERR_NETWORK',
  'OT_MEDIA_ERR_DECODE',
  'OT_MEDIA_ERR_SRC_NOT_SUPPORTED',
  'OT_SET_REMOTE_DESCRIPTION_FAILED',
  'OT_UNEXPECTED_SERVER_RESPONSE',
]);

function isRetryablePublishError(error) {
  return RETRYABLE_PUBLISH_ERRORS.has(error.name);
} Utilizar una lista de permitidos explícita es más seguro que volver a intentar cada error del que no se sabe que no se pueda reintentar. Los errores desconocidos deben registrarse e investigarse, en lugar de reintentarse automáticamente.
Antes de publicar, comprueba que los nombres de estos errores y las recomendaciones para volver a intentarlo coincidan con la versión del SDK de JavaScript de la Video API de Vonage que utiliza tu aplicación.
En el siguiente ejemplo se separa la operación de publicación de la política de reintentos:
function publishToSession(session, publisher) {
  return new Promise((resolve, reject) => {
    session.publish(publisher, (error) => {
      if (error) {
        reject(error);
        return;
      }

      resolve();
    });
  });
}

async function publishWithRetry({
  session,
  publisher,
  maxAttempts = 3,
}) {
  return retryOperation({
    operation: async () => {
      await publishToSession(session, publisher);
    },
    shouldRetry: isRetryablePublishError,
    maxAttempts,
    getDelay: (attempt) => 2000 + ((attempt - 1) * 1000),
  });
}
Aquí, shouldRetry se utiliza isRetryablePublishError para reintentar únicamente los errores incluidos en la lista de permitidos explícita. La getDelay función espera más tiempo entre los intentos posteriores, empezando por 2 segundos. Modifica maxAttempts o los valores de retardo para que se ajusten a los requisitos de recuperación de tu aplicación.
El resultado es que los fallos temporales en la publicación pueden reintentarse sin que se repitan automáticamente los errores que requieren la intervención del usuario o cambios en las aplicaciones.
Este ejemplo facilita la modificación de la política de reintentos sin necesidad de modificar la propia operación de publicación.
También establece la distinción entre los intentos y reintentos . En este ejemplo, maxAttempts: 3 significa que la aplicación realiza un máximo de tres intentos en total.
No permitas que se ejecuten varias operaciones `session.publish()` al mismo tiempo para el mismo flujo de trabajo de publicación.
Un sencillo mecanismo de protección de estado puede evitar los intentos de recuperación simultáneos:
let isPublishing = false;

async function publishSafely(options) {
  if (isPublishing) {
    return;
  }

  isPublishing = true;

  try {
    await publishWithRetry(options);
  } finally {
    isPublishing = false;
  }
} El isPublishing condición de seguridad impide que se inicie un segundo flujo de trabajo de publicación mientras ya hay uno en ejecución. Si la publicación ya está en curso, la función devuelve un valor inmediatamente. El bloque «finally» restablece la condición de seguridad, independientemente de si la publicación se realiza con éxito o falla, lo que permite que se ejecute un intento de publicación posterior.
Esta sencilla protección resulta útil para un único flujo de trabajo de publicación. En una aplicación más grande con varios editores, utiliza un estado independiente para cada editor en lugar de una variable compartida.
En una aplicación más grande, plantéate gestionar este estado en un componente dedicado al ciclo de vida del editor, en lugar de depender de una única variable global.
Un editor que no se pueda reutilizar debe eliminarse antes de que tu aplicación cree uno nuevo en su lugar.
Sin embargo, evita sustituir de forma silenciosa un editor dentro de un controlador de eventos sin actualizar el resto del estado de la aplicación.
En su lugar, centraliza la creación y la configuración de los editores.
function createConfiguredPublisher(
  container,
  publisherOptions,
  registerHandlers
) {
  const publisher = OT.initPublisher(
    container,
    publisherOptions
  );

  registerHandlers(publisher);

  return publisher;
} Este patrón garantiza que cada nuevo editor reciba los mismos controladores de eventos y la misma configuración.
Por ejemplo, si vuelves a crear un editor, recuerda registrar los controladores para eventos como:
destruido
mediaStopped
problema de adquisición de audio
Problema de adquisición de audio resuelto
Un editor recién creado es un objeto nuevo y no hereda automáticamente los oyentes asociados al editor anterior.
En los entornos compatibles, una pista multimedia puede detenerse durante la publicación. Considera esto como un evento de recuperación, pero asegúrate de que solo se ejecute un flujo de trabajo de recuperación a la vez.
function registerMediaStoppedHandler({
  publisher,
  session,
  recover,
}) {
  let isRecovering = false;

  publisher.on('mediaStopped', async () => {
    if (isRecovering) {
      return;
    }

    isRecovering = true;

    try {
      try {
        session.unpublish(publisher);
      } catch (error) {
        console.warn(
          'Unable to unpublish the publisher:',
          error
        );
      }

      await delay(2000);
      await recover();
    } finally {
      isRecovering = false;
    }
  });
} Es preferible registrar los errores inesperados a ignorarlos sin más. De este modo, tu aplicación podrá distinguir entre las condiciones previstas del ciclo de vida y los auténticos fallos de recuperación.
El proceso de recuperación concreto debe tener en cuenta si el editor existente puede seguir utilizándose o si es necesario crear uno nuevo.
Utiliza un proceso de toma de decisiones claro para los fallos en la publicación:
Condición | Medida recomendada |
El usuario deniega el permiso al dispositivo | Solicitar una acción por parte del usuario; no volver a intentarlo automáticamente de forma repetida |
La inicialización del editor falla debido a un problema de configuración permanente | Corrige la configuración antes de volver a intentarlo |
Se produce un fallo transitorio de la red, según consta en los registros | Vuelve a intentarlo aplicando una política de reintentos limitada |
El editor ha sido eliminado | Crear y configurar un nuevo editor |
Se han solicitado varios intentos de publicación | Serializar las operaciones |
Se produce un error desconocido | Registrar e investigar, en lugar de volver a intentarlo automáticamente |
Este enfoque evita dar por sentado que todos los errores tienen la misma causa.
Una suscripción puede fallar debido a condiciones temporales de la red o de la negociación de medios.
Si tu aplicación determina que es seguro volver a intentar una operación de suscripción tras un error, comprueba primero que el flujo siga estando disponible.
Un flujo puede desaparecer entre el intento fallido y el nuevo intento.
Si la aplicación ha recibido un evento «streamDestroyed», no vuelvas a intentar suscribirte a la transmisión anterior. Espera a que se produzca el evento correspondiente del ciclo de vida de la transmisión y suscríbete a la transmisión disponible en su lugar.
function subscribeToStream(
  session,
  stream,
  element,
  options
) {
  return new Promise((resolve, reject) => {
    const subscriber = session.subscribe(
      stream,
      element,
      options,
      (error) => {
        if (error) {
          reject(error);
          return;
        }

        resolve(subscriber);
      }
    );
  });
} A continuación, puedes añadir una lógica de reintento en torno a la suscripción:
async function subscribeWithRetry({
  session,
  stream,
  element,
  options,
  shouldRetry,
  maxAttempts = 3,
}) {
  return retryOperation({
    operation: async () => {
      const streamStillExists = session.streams.get(stream.id);

      if (!streamStillExists) {
        throw new Error('Stream is no longer available');
      }

      return subscribeToStream(
        session,
        stream,
        element,
        options
      );
    },
    shouldRetry,
    maxAttempts,
    getDelay: (attempt) => 3000 * attempt,
  });
} Configura shouldRetry para que devuelva «true» en el caso de errores que se haya comprobado que es seguro reintentar.
Cuando muchos clientes sufren el mismo fallo temporal, volver a intentarlo exactamente a la misma hora puede provocar otra oleada de solicitudes.
Añadir una pequeña cantidad de fluctuación puede espaciar los intentos de reintento:
function getSubscriptionRetryDelay(attempt) {
  const baseDelay = 3000  attempt;
  const jitter = Math.random()  500;

  return baseDelay + jitter;
} Utiliza una política de reintentos que se ajuste a los requisitos de tu aplicación y a la experiencia de usuario esperada.
Ten en cuenta que recomendamos un intervalo mínimo de 3 segundos entre los reintentos; no obstante, siempre puedes modificarlo para adaptarlo a tu caso de uso. No lo configures con un intervalo demasiado corto para evitar situaciones de sobrecarga o congestión.
El hecho de que la publicación se haya realizado correctamente no garantiza que el audio siga sonando durante toda la sesión.
El SDK puede proporcionar eventos que indiquen un problema de captación de audio y, en algunos casos, que el problema se ha resuelto.
Si tu aplicación recibe un audioAcquisitionProblem evento, comprueba los detalles del mismo y aplica la estrategia de recuperación documentada para la causa indicada.
En el caso de una situación detectada mediante estadísticas, tu aplicación puede optar por esperar unos instantes antes de actuar.
const RECOVERY_TIMEOUT_MS = 3000;

let recoveryTimeoutId = null;

publisher.on('audioAcquisitionProblem', ({ method }) => {
  if (method !== 'getStats') {
          // This indicates a non-transient error. You may want to recreate the
    // publisher.
    return;
  }

  if (recoveryTimeoutId !== null) {
    return;
  }

  recoveryTimeoutId = setTimeout(() => {
    recoveryTimeoutId = null;

    // Select an appropriate recovery action for your application.
    // For example, prompt the user to choose another audio device
    // or recreate the publisher.
  }, RECOVERY_TIMEOUT_MS);
}); No des por sentado que siempre hay disponible un identificador de dispositivo alternativo. Si tu aplicación tiene previsto cambiar de dispositivo de audio, explica cómo selecciona dicho dispositivo y qué ocurre cuando no hay ningún dispositivo de sustitución disponible.
Si el problema se resuelve antes de que expire el tiempo de espera de la recuperación, cancela la acción de recuperación pendiente.
publisher.on(
  'audioAcquisitionProblemResolved',
  () => {
    if (recoveryTimeoutId !== null) {
      clearTimeout(recoveryTimeoutId);
      recoveryTimeoutId = null;
    }
  }
);
No se debe considerar que todos los métodos de evento que no sean getStats como el mismo fallo.
En su lugar, gestiona de forma explícita los valores de los eventos documentados:
publisher.on('audioAcquisitionProblem', ({ method }) => {
  if (method === 'getStats') {
    // Handle a potentially temporary problem.
    return;
  }

  if (method === 'trackEndedEvent') {
    // Handle an ended track using the documented
    // publisher recovery workflow.
    return;
  }

  console.warn(
    'Received an unknown audio acquisition problem method:',
    method
  );
}); Esto evita que unos valores inesperados provoquen automáticamente un comportamiento de recuperación destructivo.
Los siguientes ajustes sirven como punto de partida. Adáptalos a los requisitos de tu aplicación.
Parámetro | Valor inicial recomendado | Notas |
Número máximo de intentos de conexión | 3 | Limita el tiempo dedicado a los nuevos intentos |
Retardo en el reintento de conexión | Retraso lineal | Aumentar el tiempo de espera entre intentos |
Número máximo de intentos de publicación | 3 | Reintentar solo los errores transitorios verificados |
Retardo de reintento en la publicación | 2 segundos, y luego va aumentando | Evita realizar intentos repetidos de forma inmediata |
Retardo entre intentos de suscripción | Al menos 3 segundos | Verify primero si el flujo sigue existiendo |
Fluctuación en el tiempo de reintento | Opcional | Ayuda a distribuir los reintentos simultáneos |
Errores desconocidos | No volver a intentarlo automáticamente | Registrar e investigar el fallo |
Una recuperación fiable no consiste simplemente en volver a ejecutar una operación.
Un proceso de recuperación completo debería responder a las siguientes preguntas:
¿Es un fallo temporal?
¿Es seguro volver a intentarlo?
¿Es necesario liberar el objeto anterior?
¿Ha cambiado el estado de la sesión o de la transmisión?
¿Podría ser que ya se estuviera llevando a cabo otro intento de recuperación?
¿La aplicación requiere que el usuario introduzca datos?
¿Qué debería pasar si fallan todos los intentos?
Centralizar el comportamiento de los reintentos facilita la aplicación coherente de estas decisiones.
Además, sigue los principios de buen diseño de software al separar:
la operación que se está realizando
la política de reintentos
clasificación de errores
gestión del ciclo de vida de las editoriales
Esto reduce la duplicación y facilita la ampliación de la estrategia de recuperación a medida que cambia tu aplicación.
El equipo de la Video API de Vonage sigue mejorando la resiliencia y el comportamiento de recuperación en el SDK. Las futuras versiones del SDK incorporarán más funciones de resiliencia integradas, lo que reducirá la cantidad de lógica de recuperación que las aplicaciones deben gestionar por sí mismas.
A medida que evolucionen las funciones de resiliencia a nivel del SDK, revisa la lógica de reintentos a nivel de la aplicación para asegurarte de que complemente al SDK en lugar de duplicar su comportamiento innecesariamente.
También puedes echar un vistazo a la aplicación Vonage Video React para ver un ejemplo de estructura de aplicación orientada a la producción. Revisa la implementación con atención y adapta los patrones de recuperación a la versión actual del SDK de tu aplicación y a sus requisitos.
Las aplicaciones de video fiables deben prever fallos temporales y gestionarlos mediante estrategias de recuperación bien planificadas.
Los patrones más importantes son:
limpiar el estado de la sesión antes de volver a intentar establecer una conexión
distinguir entre los errores que requieren una acción por parte del usuario y los que se pueden volver a intentar
Utiliza listas de permitidos explícitas para los errores que admiten reintentos
evitar que se produzcan simultáneamente operaciones de publicación y recuperación
Verify que un flujo sigue existiendo antes de volver a intentar una suscripción
gestionar la limpieza y la recreación de los editores a lo largo de un ciclo de vida coherente
supervisar los problemas de adquisición de audio y aplicar la estrategia de recuperación adecuada
Antes de añadir reintentos automáticos, Verify el comportamiento de la versión concreta del SDK que utiliza tu aplicación. Una política de reintentos debe basarse en el comportamiento documentado y haberse probado ante fallos reales de red y de dispositivos.
¿Quieres aprender, mantenerte al día o compartir lo que estás creando?
Sigue aprendiendo
Explora casos de uso y itinerarios de aprendizaje estructurados en el Centro de formación de Vonage
Mira los tutoriales en nuestro canal de YouTube de Vonage Developer
Mantente conectado
Suscríbete al boletín informativo para desarrolladores de Vonage
Síguenos en X para estar al día
Síguenos en LinkedIn
Ayúdanos a mejorar nuestra experiencia como desarrolladores rellenando nuestro cuestionario «La voz del desarrollador»
Compartir:
Alberto is a Senior Software Engineer at Vonage, with deep experience in the Video product across the Ecosystem, Platform Quality, and Video API teams. He thrives at the intersection of front-end craft and back-end logic. Having lived in Barcelona, Sydney, and San Francisco, he brings over a decade of building and shaping the visible side of real-time platforms and a growing focus on agentic AI product development.