Compartir:

Julia está comprometida con la capacitación de los desarrolladores mediante la creación de tutoriales, guías y recursos prácticos. Con experiencia en divulgación y educación, su objetivo es hacer que la tecnología sea más accesible y mejorar la experiencia general de los desarrolladores. A menudo se la puede encontrar en eventos de la comunidad local.
De las conversaciones frustrantes a la asistencia técnica por Video en directo con Jev y Vonage
Tiempo de lectura: 10 minutos
Los chatbots son excelentes para responder rápidamente a preguntas habituales. Sin embargo, resultan menos útiles cuando un cliente se encuentra en un atolladero, se siente cada vez más frustrado o, simplemente, quiere hablar con otra persona. La mayoría de los bots o bien no se dan cuenta de ello en absoluto, o bien responden con un «Siento oír eso» totalmente fuera de lugar antes de volver a hacer la misma pregunta, lo que muy probablemente acabará por hacer que se pierda al cliente.
¿Y si tu aplicación pudiera detectar ese momento e involucrar a un agente humano en el momento adecuado?
Sigue estos pasos para crear una interfaz de atención al cliente basada en el modelo Jev de TypeSafe AI de TypeSafe AI, que evalúa continuamente el estado emocional de la conversación y, a continuación, ofrece una videollamada en directo a través de la Video API de Vonage en el momento en que las cosas empiecen a torcerse.
Veamos cómo funciona todo, desde la lógica de evaluación de la IA hasta la señalización en tiempo real que conecta a un cliente frustrado con una persona que realmente pueda ayudarle.
En resumen: Haz un fork del repositorio y pruébalo tú mismo en GitHub
La aplicación tiene dos aspectos:
Perspectiva del cliente: Una interfaz de chat en la que los usuarios interactúan con un agente de atención al cliente (simulado) basado en IA.
Panel de control del empleado: Una vista en tiempo real en la que el personal de asistencia técnica puede ver las solicitudes de escalado entrantes, con detalles sobre el motivo por el que se ha escalado la solicitud del usuario y un botón «Responder a la llamada» para unirse a una videollamada.
El elemento que los conecta es un backend de Node.js/Express que:
Analiza cada mensaje de los clientes mediante el modelo Jev de TypeSafe AI para evaluar el sentimiento y el grado de frustración
Decide si se debe escalar el caso basándose en puntuaciones estructuradas generadas por IA
Utiliza la señalización de Video de Vonage para transmitir los eventos de escalado al panel de control de los empleados en tiempo real
Inicia una sesión de Video de Vonage para la llamada en directo cuando un agente humano responde la llamada
Esta es la arquitectura general: 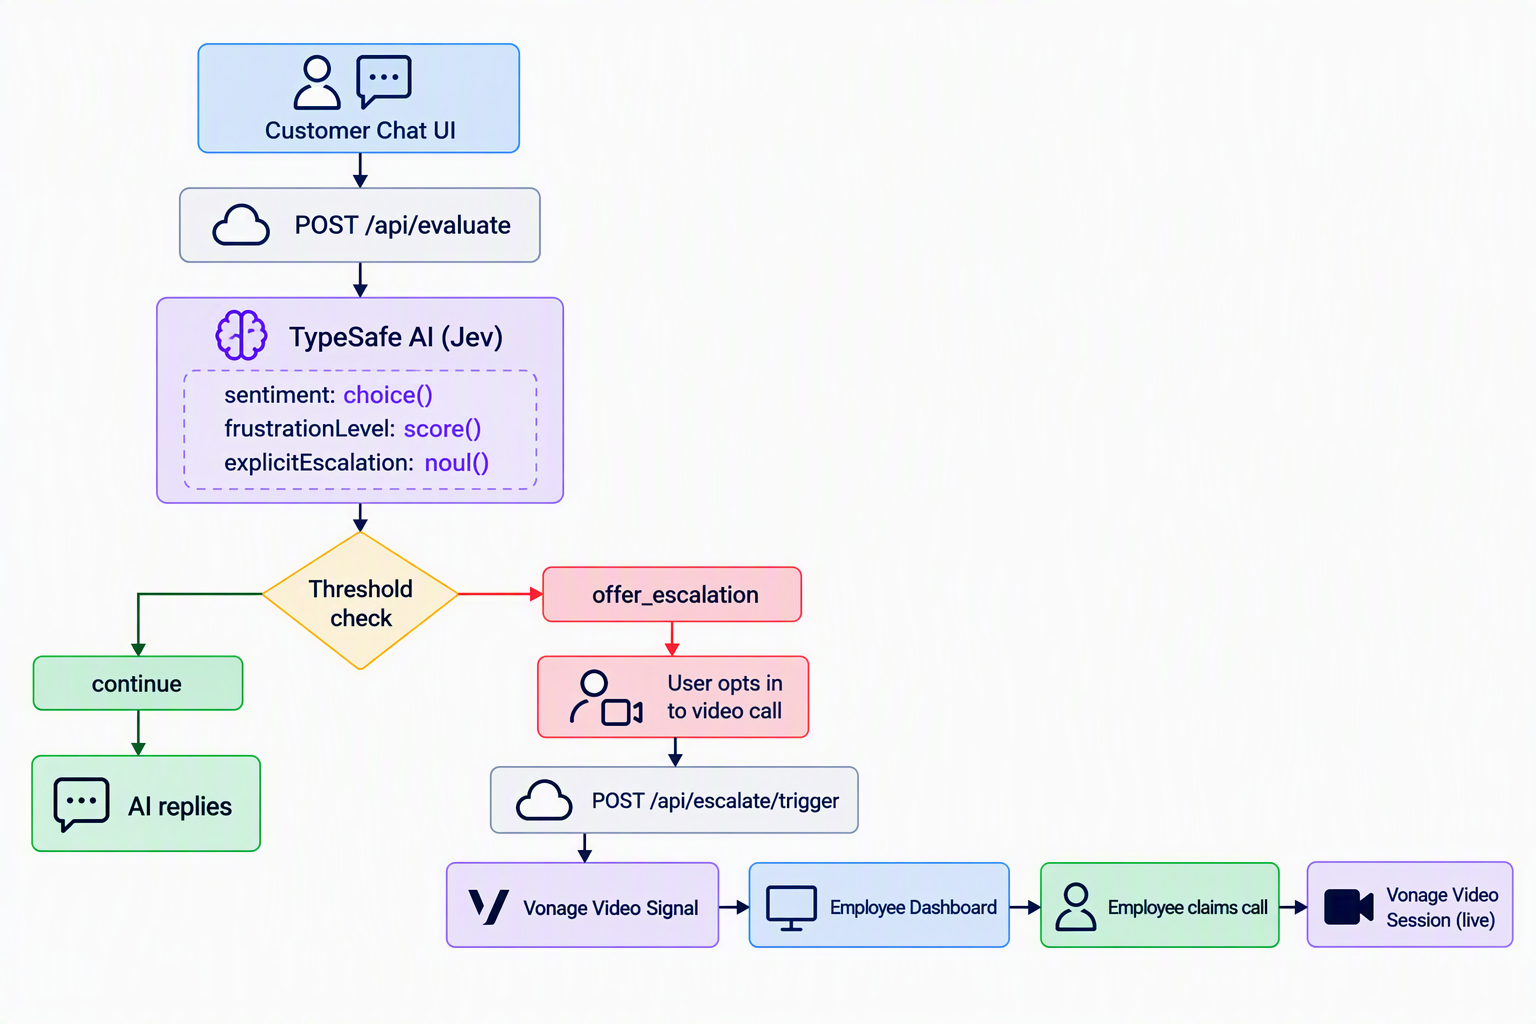
Node.js 22+
Typesafe AI Account
A cuenta de GitHub Account
La forma más rápida de ejecutarlo es con GitHub Codespaces, sin necesidad de configuración local.
Bifurcación Crea una bifurcación en tu cuenta de GitHub
Haz clic en Código → Espacios de código → Crear espacio de código en la página principal
El script setup.js incluido se ejecuta automáticamente y te guía a través de tres pasos:
Tu clave API de Vonage y el secreto de la API (del panel de control de Vonage)
Tu Clave de la API de TypeSafe AI (de la consola de TypeSafe AI)
Un nombre para tu aplicación de Vonage
El script de configuración llama a la API de Vonage para crear una aplicación con función de Video, guarda la clave privada y escribe toda la información en un .env archivo. Después, solo hay que npm start.
Aquí es donde la cosa se pone interesante. La mayoría de las integraciones de detección de sentimiento introducen el texto del mensaje en un modelo de lenguaje grande (LLM) y extraen texto en formato libre de la respuesta. Ese enfoque es poco robusto. El formato de salida puede variar, el nivel de confianza es opaco y, en esencia, lo que se está haciendo es comparar cadenas de caracteres en un texto generado por IA.
TypeSafe AI’s Jev de TypeSafe AI adopta un enfoque diferente. En lugar de pedir una respuesta de texto, tú proporcionas un historial (el historial de la conversación, en nuestro caso) y formules preguntas tipificadas (también conocidas como primitivas) con formatos de respuesta restringidos.
El modelo evalúa la información que introduces y devuelve respuestas estructuradas y legibles por máquina, con puntuaciones de confianza integradas. Piensa en ello como un lenguaje de consulta tipado para la inferencia de la IA.
Los tres tipos de preguntas disponibles son:
Función | Para qué sirve |
| Devuelve una de las etiquetas de un conjunto predefinido, junto con una puntuación de confianza. |
| Devuelve una puntuación numérica en una escala etiquetada |
| Devuelve una probabilidad (0–1) para una pregunta de sí o no |
Aquí tienes la grabación completa de la reunión de evaluación de server.js:
import { TypeSafeClient, score, noul, choice } from '@typesafe-ai/sdk';

const jev = new TypeSafeClient(); // reads TYPESAFE_API_KEY from .env

const evaluation = await jev.systemOne({
  state: messages, // the full conversation history
  questions: {
    sentiment: choice("What is the user's current sentiment?", {
      happy: null,
      neutral: null,
      confused: null,
      frustrated: null,
      angry: null
    }),
    frustrationLevel: score("How frustrated is the user?", [
      "Calm, neutral, or happy",            // 0
      "Slightly annoyed but polite",        // 1
      "Visibly frustrated or impatient",    // 2
      "Extremely angry, aggressive, or rude" // 3
    ]),
    explicitEscalation: noul("Does the user explicitly ask to speak to a human, agent, or representative?")
  }
}); Hay algunas cosas que conviene destacar aquí:
El historial completo de la conversación se pasa como estado. Esto significa que Jev evalúa la trayectoria, no solo el último mensaje. Un usuario que se mostraba neutral hace dos mensajes, pero que ahora está frustrado, obtendrá una puntuación diferente a la de alguien que ha estado frustrado desde el principio, y ese contexto es importante para las aplicaciones de asistencia.
choice() devuelve tanto una etiqueta como una puntuación de confianza. Se obtiene evaluation.answers.sentiment.choice (por ejemplo, «frustrado») y evaluation.answers.sentiment.confidence (por ejemplo, 0,91). Esto permite establecer distintos umbrales para los diferentes estados emocionales y evitar actuar basándose en conjeturas con baja confianza.
score() devuelve un valor numérico en una escala continua, y no solo la etiqueta más cercana. Aunque la escala tiene cuatro puntos con nombre, el modelo devuelve un valor de tipo flotante. Esto significa que puedes detectar estados «intermedios», como una puntuación de 1,7 (en camino hacia la frustración, pero sin haberla alcanzado aún), y tomar decisiones matizadas.
noul() está diseñado específicamente para preguntas de probabilidad. En lugar de pedirle al modelo que responda «sí» o «no», este devuelve una probabilidad entre 0 y 1. En esta demostración, una puntuación superior a 0,8 se considera una solicitud explícita y confirmada de intervención humana.
Una vez obtenida la evaluación, el servidor realiza una comprobación del umbral:
const userSentiment = evaluation.answers.sentiment.choice;
const userSentimentConfidence = evaluation.answers.sentiment.confidence;
const frustrationScore = evaluation.answers.frustrationLevel.score;
const wantsHuman = evaluation.answers.explicitEscalation.noul > 0.8;

if (
  frustrationScore >= 2 ||
  (['frustrated', 'angry'].includes(userSentiment) && userSentimentConfidence > 0.8) ||
  wantsHuman
) {
  // Offer escalation
  return res.json({
    action: 'offer_escalation',
    sentiment: userSentiment,
    frustrationLevel: frustrationLevel,
    lastMessage: messages[messages.length - 1].text,
    message: wantsHuman || userSentiment === 'angry'
      ? "I'll connect you to a live agent."
      : "It seems like you might need more help than I can offer. Would you like to connect with a live agent?"
  });
}

// Otherwise, pass to the AI agent to continue the conversation
return res.json({ action: 'continue' }); Los tres factores desencadenantes de la escalada abarcan casos distintos:
frustrationScore >= 2: Detecta la frustración en el comportamiento: respuestas breves, preguntas repetidas, impaciencia evidente, incluso si el usuario no ha dicho explícitamente que esté molesto
Sentimiento + confianza: Aumenta cuando el modelo está seguro de que el usuario está frustrado o enfadado, basándose en el tono emocional del propio lenguaje.
wantsHuman: Detecta peticiones directas: «¿Puedo hablar con alguien?», «Quiero hablar con una persona de verdad», etc.
Si la llamada a Jev falla por completo (error de red, problema con la API), el servidor devuelve { action: 'continue' } como medida de seguridad. La experiencia de chat nunca se interrumpe, simplemente continúa sin que se produzca una escalación.
Cuando el cliente acepta la videollamada, la aplicación debe realizar dos acciones: notificarlo al panel de control del empleado y establecer la sesión de vídeo propiamente dicha. Vonage se encarga de ambas cosas.
La aplicación utiliza dos tipos de sesiones de Vonage Video:
Las sesiones de los clientes son únicas para cada cliente y se crean bajo demanda cuando un usuario abre la aplicación por primera vez. Estas sesiones incluyen un token de editor, por lo que están listas para acceder a sus respectivas sesiones de Video.
app.get('/api/auth/customer', async (req, res) => {
  const session = await vonage.video.createSession({ mediaMode: 'routed' });
  const token = vonage.video.generateClientToken(session.sessionId, {
    role: 'publisher'
  });
  res.json({
    applicationId: process.env.VONAGE_APPLICATION_ID,
    sessionId: session.sessionId,
    token: token
  });
}); La sesión de despacho es una única sesión compartida a la que se conectan todos los empleados como suscriptores. No transmite Video; se trata exclusivamente de un canal de señalización para difundir eventos de escalado a través del panel de control en tiempo real.
app.get('/api/auth/dispatch', async (req, res) => {
  const dispatchSessionId = await getDispatchSessionId();
  const token = vonage.video.generateClientToken(dispatchSessionId, {
    role: 'subscriber'
  });
  res.json({ applicationId, dispatchSessionId, dispatchToken: token });
}); De esta forma, utilizamos una sesión persistente y de bajo coste como canal de notificaciones, y mantenemos las sesiones de Video aisladas en cada llamada individual.
Cuando el cliente hace clic en «Conectarme con un agente», el cliente envía una solicitud a /api/escalate/trigger. A continuación, el servidor utiliza Vonage Video Signaling para transmitir un evento de escalación a todos los suscritos a la sesión de despacho (los empleados):
await vonage.video.sendSignal({
  type: 'escalation',
  data: JSON.stringify({
    customerId,
    sessionId,       // the customer's unique video session
    sentiment,
    frustrationLevel,
    lastMessage
  })
}, dispatchSessionId); El navegador de cada empleado recibe esta señal y muestra una ficha en el panel de control en la que se indica el contexto emocional del cliente (etiqueta de sentimiento, nivel de frustración y último mensaje), junto con un botón que dice «Responder a la llamada».
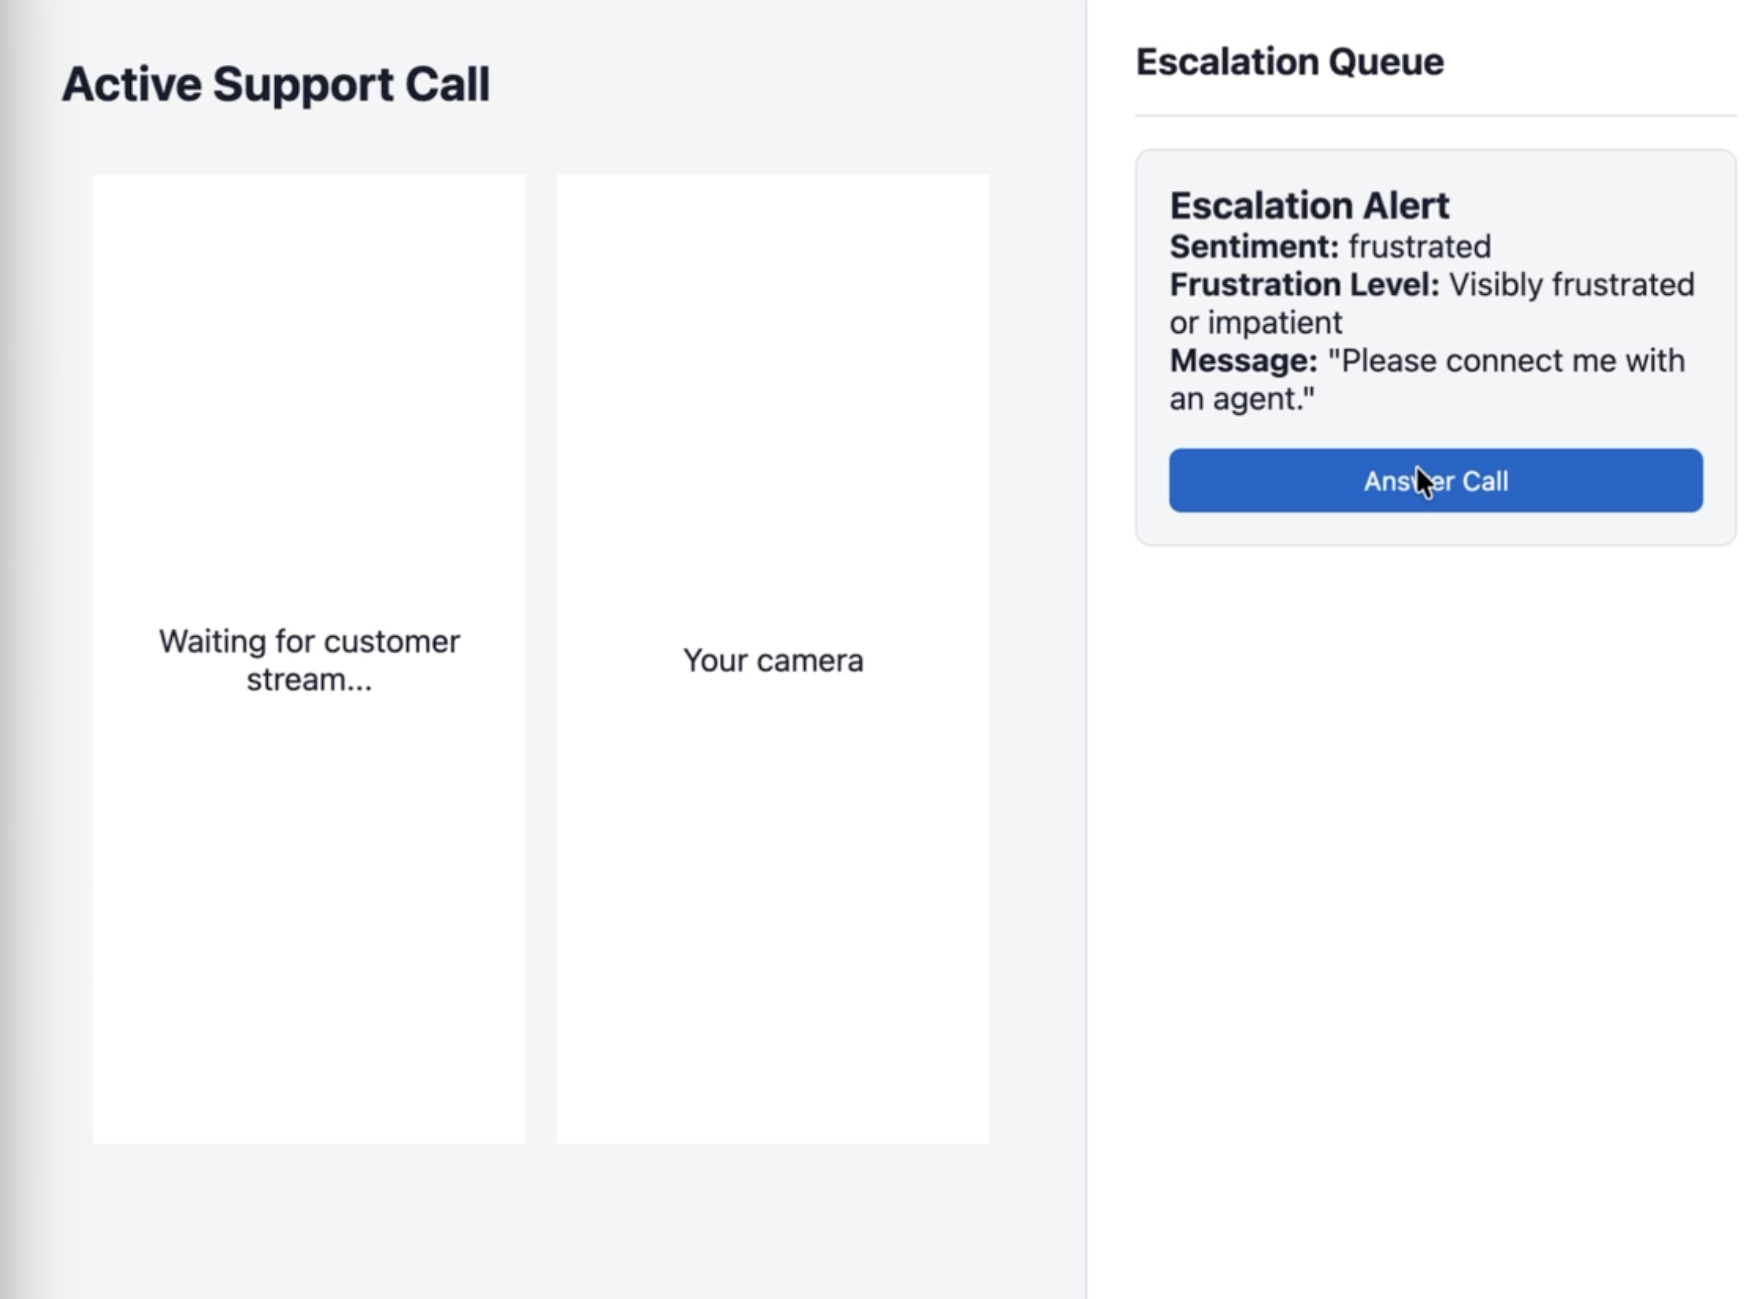 Employee Dashboard Showing Escalation Queue
Cuando un empleado hace clic en «Contestar llamada», ocurren dos cosas:
Se
claimedse envía una señal a la sesión de despacho, por lo que la tarjeta desaparece de los paneles de control de los demás empleadosEl empleado recibe un token de editor para la sesión de Video específica de ese cliente y se une a la llamada
// Claim the call — remove it from other dashboards
await vonage.video.sendSignal({
  type: 'claimed',
  data: JSON.stringify({ customerId })
}, dispatchSessionId);

// Join the customer's session as a publisher
const token = vonage.video.generateClientToken(sessionId, { role: 'publisher' }); Por parte del cliente, la interfaz de usuario es un elemento estándar <dialog> con dos contenedores de Video: uno para el feed del editor del propio cliente y otro para el flujo de los empleados suscritos.
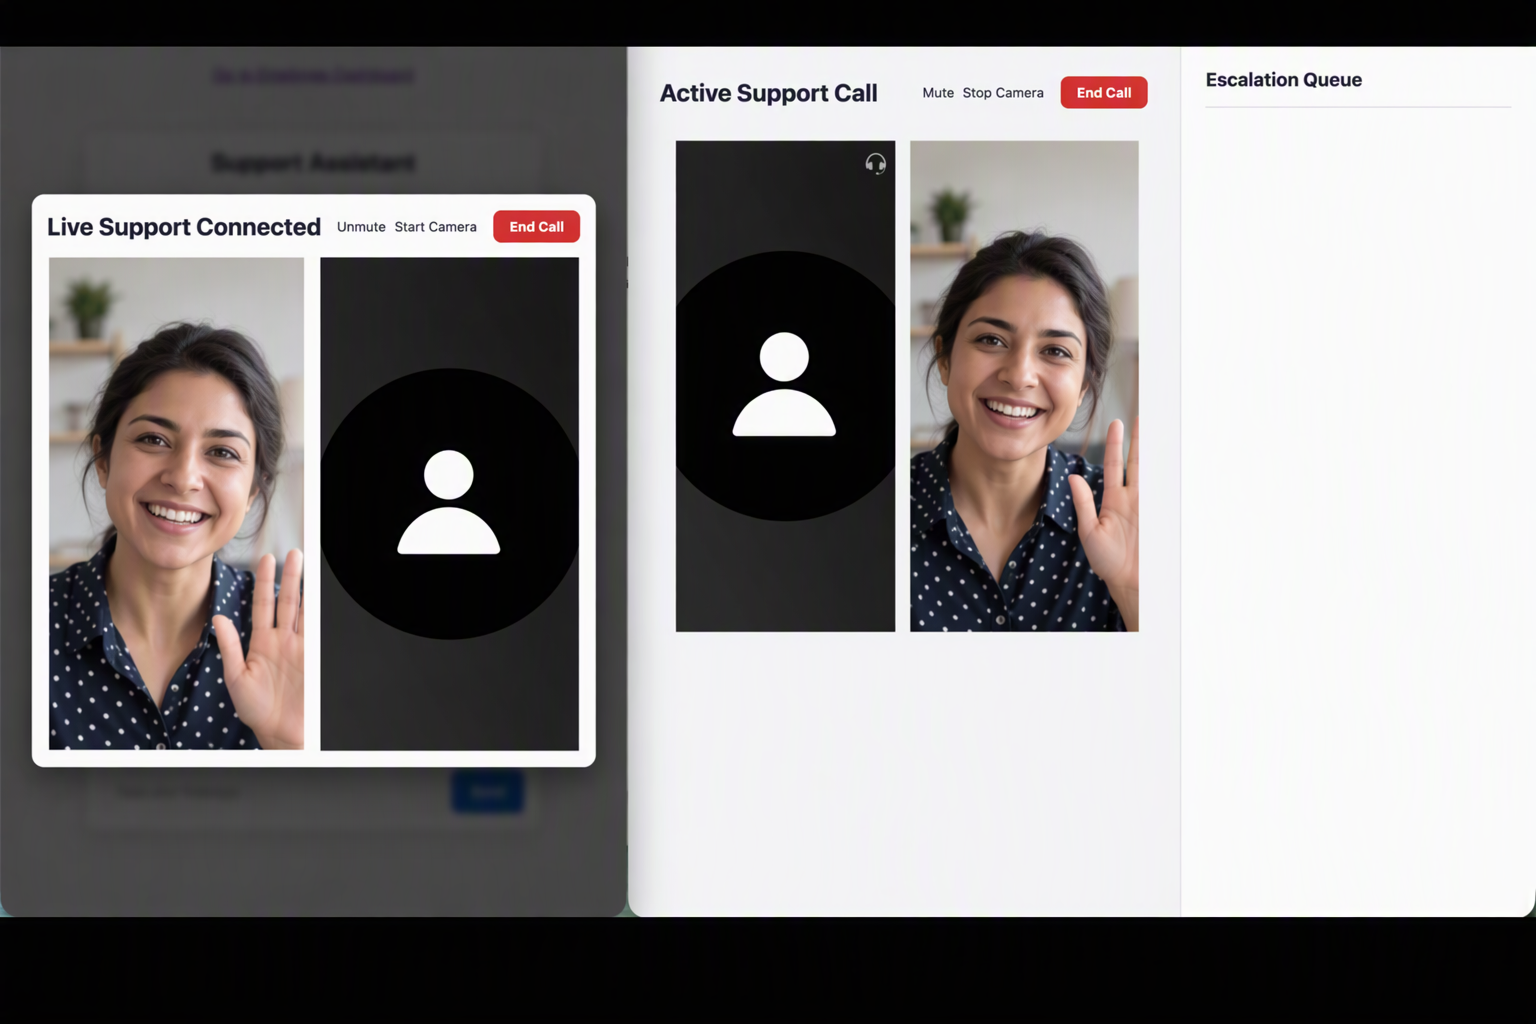 Screenshot of Customer View and Employee Dashboard Side by Side
Este es el recorrido completo, desde el cliente frustrado hasta la videollamada en directo:
El cliente envía un mensaje por chat → el cliente envía mediante un método POST el historial de la conversación a
/api/evaluateEl servidor transmite el historial completo a Jev a través de
jev.systemOne()- recuperando el sentimiento, la puntuación de frustración y la probabilidad de escaladoEl servidor compara las puntuaciones con los umbrales. Si se supera algún umbral, devuelve una acción:
'offer_escalation'El cliente acepta → el cliente envía una solicitud POST a
/api/escalate/triggerEl servidor envía una señal de Video de Vonage en la sesión de envío, que incluye el identificador de sesión del cliente y el contexto emocional.
El navegador del empleado recibe la señal → aparece una ficha en el panel de control
El empleado hace clic en «Contestar llamada» → el servidor emite
claimed, devuelve un token de editor para la sesión del clienteAmbas partes se encuentran ahora en la misma sesión de Vonage Video
Este repositorio está diseñado para que puedas pasar de cero a tener una demo funcional en menos de cinco minutos utilizando GitHub Codespaces:
Bielas: https://github.com/Vonage-Community/demo-video-javascript-jev-starter
Abrir en Codespaces → ejecutar
setup.jsautomáticamenteIntroduce tus credenciales de Vonage + TypeSafe AI
npm start
Una vez que el servidor esté en funcionamiento, abre dos pestañas del navegador (una para la vista del cliente y otra para el panel de control del empleado) e intenta escribir algo como «Ya lo he explicado tres veces y nadie me está ayudando». Observa qué resultado devuelve Jev y cómo responde el panel de control.
Esta demostración es, a propósito, un punto de partida. A continuación te proponemos algunas ideas que merece la pena explorar a continuación:
Realiza uno de nuestros itinerarios de aprendizaje sobre la Video API
Lo que hace que esta demostración sea interesante no es solo la videollamada, sino el nivel de toma de decisiones que la activa. La combinación de la señalización en tiempo real de Vonage Video y la evaluación estructurada de TypeSafe AI hace que la lógica de escalado sea explícita, ajustable y depurable. No se trata de analizar el sentimiento a partir de una respuesta de un modelo de lenguaje grande (LLM) de formato libre y cruzar los dedos; se trata de consultar al modelo con preguntas tipificadas y obtener respuestas estructuradas.
Es un modelo que merece la pena seguir desarrollando. Este mismo ciclo de evaluación podría servir de base para intervenciones de asistencia proactivas, la priorización automática de incidencias o el control de calidad de las conversaciones de los agentes. Pruébalo en cualquier contexto en el que necesites extraer señales fiables y útiles a partir del lenguaje natural en tiempo real.
¿Quieres aprender, mantenerte al día o compartir lo que estás creando?
Sigue aprendiendo
Explora casos de uso y itinerarios de aprendizaje estructurados en el Centro de formación de Vonage
Mira los tutoriales en nuestro canal de YouTube de Vonage Developer
Mantente conectado
Suscríbete al boletín informativo para desarrolladores de Vonage
Síguenos en X para estar al día
Síguenos en LinkedIn
Ayúdanos a mejorar nuestra experiencia como desarrolladores rellenando nuestro cuestionario «La voz del desarrollador»
Compartir:
Julia está comprometida con la capacitación de los desarrolladores mediante la creación de tutoriales, guías y recursos prácticos. Con experiencia en divulgación y educación, su objetivo es hacer que la tecnología sea más accesible y mejorar la experiencia general de los desarrolladores. A menudo se la puede encontrar en eventos de la comunidad local.