Teilen Sie:

Benjamin Aronov ist ein Entwickler-Befürworter bei Vonage. Er ist ein bewährter Community Builder mit einem Hintergrund in Ruby on Rails. Benjamin genießt die Strände von Tel Aviv, das er sein Zuhause nennt. Von Tel Aviv aus kann er einige der besten Startup-Gründer der Welt treffen und von ihnen lernen. Außerhalb der Tech-Branche reist Benjamin gerne um die Welt auf der Suche nach dem perfekten Pain au Chocolat.
Über das „Vibe Coding“ hinaus: Best Practices im Jahr 2026
Lesedauer: 17 Minuten
In diesem Beitrag erfahren Sie mehr über die Best Practices für die KI-Programmierung, Arbeitsabläufe und agentische Entwicklungsmuster, die echte Teams im Jahr 2026 anwenden.
In den letzten acht Monaten bin ich nach und nach von Tel Aviv nach New York gezogen. Der Umzug hat sich gelohnt, aber ich konnte mit dem wöchentlichen Wirbelwind an Trends im Bereich der KI-Programmierung nicht Schritt halten.
Und in der KI-Programmierung kommen einem acht Monate wie ein Jahrzehnt vor.
Das letzte Mal, dass ich meinen Arbeitsablauf grundlegend überarbeitet habe, war etwa im Dezember 2025. Damals habe ich Windsurf zusammen mit Cascade verwendet (heute bekannt als Devin) und wechselte dann zu Claude-Modelle, und die wichtigste Erkenntnis damals war, eine sehr eigenwillige CLAUDE.md -Datei zu implementieren: zuerst planen, Änderungen einfach halten, Tests schreiben, Tests ausführen, die Ursachenanalyse nicht überspringen.
Die nützlichste Regel war zugleich auch die unspektakulärste:
Überlege dir zunächst, worum es bei dem Problem geht, lies die entsprechenden Dateien durch und erstelle einen Plan in Form einer Checkliste für tasks/todo.md , bevor du mit dem Programmieren beginnst.
Diese eine Änderung hat meine Entwicklung wirklich beflügelt. Meine Sitzungen verliefen zielgerichtet, die „Agenten-Halluzinationen“ nahmen deutlich ab, und ich konnte Tickets viel schneller abarbeiten.
Deshalb wollte ich wissen: „Welche neuen Superkräfte sind in den letzten sechs Monaten entstanden?“
Ich habe einen Tag damit verbracht, das zu tun, was die meisten Entwickler heutzutage wahrscheinlich tun, wenn sie sich schnell auf den neuesten Stand bringen müssen: Ich habe Claude, Grok und ChatGPT gebeten, die neuesten Trends im Bereich der KI-Programmierung zu recherchieren, und sie dann gegeneinander argumentieren lassen. Aber ich war nicht auf der Suche nach der neuesten Demo. Ich wollte wissen, was sich tatsächlich durchgesetzt hat.
Anschließend habe ich die Ergebnisse mit etwa 15 Personen abgeglichen, auf deren Urteil ich vertraue: CTOs, Gründer von Start-ups, KI-Forscher, Backend-Leiter, Teamleiter und erfahrene Entwickler, die diese Tools in realen Codebasen einsetzen.
Das habe ich herausgefunden.
 Share the AI coding workflows and practices that have proven useful in production.Ich würde gerne mehr über deinen Programmier-Workflow erfahren. Bitte antworte in diesem LinkedIn-Beitrag Beitrag.
Jeden Tag tauchen in den sozialen Medien neue, raffiniert gestaltete Demos auf. „Dieses Framework verzehnfacht die Leistung Ihres Maklers!“ „Wenn Sie dieses neue Tool nicht nutzen, hinken Sie schon hinterher!“ Aber es ist schwer zu unterscheiden, was echt ist und was nur Hype.
„Vibe-Coding“ – dieser Begriff Andrej Karpathy , hat die Softwareentwicklung revolutioniert: Programmieren durch die Beschreibung der Absicht, das Akzeptieren generierter Änderungen und das Feintuning des Modells, bis die App funktioniert. Es ist kaum zu glauben, dass wir jemals anders vorgegangen sind. Das Collins Dictionary kürte den Begriff zum Wort des Jahres 2025. Seriöse Produktionsteams haben jedoch zwei Konzepte voneinander getrennt, die früher oft in einem Atemzug genannt wurden: den Einsatz von KI zur Codegenerierung und die Übernahme von KI-generiertem Code ohne ausreichende Struktur oder Überprüfung.
Das Erste wird uns erhalten bleiben. Das Zweite ist das Problem. Eine Analyse von CodeRabbit von 470 realen GitHub-Pull-Requests ergab, dass von KI mitverfasster Code etwa 1,7-mal mehr Fehler enthielt als von Menschen geschriebener Code, wobei die Sicherheitslücken bis zu 2,7-mal häufiger auftraten. Der Code funktioniert. Aber er erfordert mehr Prüfung als je zuvor.
Das ist der Übergang vom „Vibe-Coding“ zu dem, was man als „Agentic Engineering“. Der Agent kann Dateien prüfen, Code schreiben, Befehle ausführen, Tests generieren, Fehler beheben und seine eigenen Ergebnisse bewerten. Aber man braucht dennoch einen entsprechenden Entwicklungsprozess drumherum. Vor allem, wenn es um die Produktion geht.
Der Hype-Zyklus in den sozialen Medien vermittelt den Eindruck, als würde jeder ständig seinen Workflow aktualisieren: spezifikationsgesteuerte, Multi-Agent-basierte, cloud-orchestrierte, MCP-vernetzte Pipelines, bei denen alles autonom abläuft.
Also habe ich eine kleine, aber aussagekräftige Gruppe von Freunden mit großer Verantwortung gefragt, wie sie vorgehen. Meistens taten sie etwas Einfacheres, als das Internet glauben machen möchte: ein leistungsstarker Programmier-Agent, ein Planungsschritt, eine Repo-Anweisungsdatei, Tests, manuelle Überprüfung, gelegentlicher Modellwechsel und manchmal ein zweites Modell für Red-Team-Tests.
Ein CTO drückte es so aus:
„Plane immer zuerst. Sag niemals einfach nur ‚Mach das!‘, selbst bei kleinen Aufgaben nicht, sonst übersehen sie etwas.“
Ein Teamleiter sagte:
„Plane so lange, bis alles perfekt aussieht, und dann setze es um. Nichts Ausgefallenes.“
Und eine erfahrene Full-Stack-Entwicklerin beschrieb ihren Zero-Trust-Ansatz:
„Ich lasse das System Tests erstellen, dann lasse ich es seine eigenen Tests prüfen. Anschließend setze ich einen weiteren Red-Team-Agenten ein. Und schließlich führe ich manuelle Tests durch. Wenn es um Geld oder den Lebenszyklus geht, immer manuell.“
Es ist mittlerweile ziemlich klar geworden, dass die Hauptaufgabe des Menschen nun darin besteht, gemeinsam mit dem Agenten einen perfekten Plan zu erstellen. Meine Anleitung tasks/todo.md hat nun ausgefallenere Namen.
Die spezifikationsgesteuerte Entwicklung ist die „saubere“ Variante: Man beginnt mit einer Absicht, wandelt diese in eine Spezifikation um, erstellt einen Implementierungsplan, unterteilt diesen in Aufgaben und lässt den Entwickler erst dann den Code schreiben. GitHub hat dies mit seinem „Spec Kit“ formalisiert als spec.md, plan.mdund tasks.md. AWS Kiro verwendet Spezifikationen als strukturierte Artefakte zur Nachverfolgung und Nachvollziehbarkeit.
Derselbe Ansatz findet sich auch in den Tools wieder. Claude Code verfügt über /goal, das Claude anweist, so lange weiterzuarbeiten, bis eine überprüfbare Abschlussbedingung erfüllt ist: Alle Tests sind bestanden, jeder TypeScript-Fehler ist behoben und die Migration ist abgeschlossen. Im Hintergrund prüft ein leichtgewichtiges Auswertungsmodell nach jeder Iteration, ob das Ziel objektiv erreicht wurde, sodass der Agent autonom so lange eine Schleife durchläuft, bis er konvergiert oder ein Budget erreicht. Codex hat dasselbe Konzept, mit Zuständen wie „pursuing“, „paused“, erreichtund budgetbegrenzt , die auch nach einem Neustart der Sitzung bestehen bleiben.
Das ist die produktreife Version einer tasks/todo.md: ein beständiges Ziel, zu dem der Agent zurückkehren kann, nun mit mehr Autonomie in diesem Bereich.
Es ist auch der Punkt, an dem Autonomie teuer wird. Wenn die Bedingung für die Fertigstellung unklar ist, kann der Agent lange Zeit in einer Schleife verharren und dennoch nicht das Richtige tun. Autonomie ohne Sicherheitsvorkehrungen ist lediglich ein schnellerer Weg, Geld zu verschwenden.
Bei nicht trivialen Aufgaben sollte der Mitarbeiter vor der Bearbeitung des Codes drei Fragen beantworten: Was ändern wir? Welche Dateien und Funktionen sind davon betroffen? Woran erkennen wir, dass es funktioniert hat?
Testgetriebene Entwicklung (TDD) wurde immer als Evangelium gepredigt, in der Praxis jedoch weitaus seltener umgesetzt. Mit dem „Agentic Coding“ gehört die Investition in Tests nun zu den Hauptaufgaben eines Entwicklers. Ein CTO, der diese Methode frühzeitig eingeführt hat, sagte mir: „Ich bin ein bisschen hin und her gerissen, wenn es darum geht, den Plan zu formulieren. Für jede Funktion, die ich entwickle, lasse ich sehr umfangreiche Tests schreiben. So weiß ich, dass sie funktioniert, wenn sie fertig ist.“
Wenn der Sachbearbeiter das nicht notieren kann, ist es noch nicht bereit für die Kodierung.
Mein alter Arbeitsablauf basierte auf einer großen CLAUDE.md Datei. Ich habe sie mit Regeln und Hervorhebungen gefüllt: SEI NICHT FAUL. LASS NIEMALS TESTS AUS. MACH ALLES SO EINFACH WIE MÖGLICH. Damit wollte ich sicherstellen, dass der Agent diszipliniert blieb und keine Abstriche machte.
Und diese Art der Anleitung hat sich bewährt. Bis 2025 verfügte jeder Anbieter von Agenten-Lösungen über eine Form von Anweisungen auf Repo-Ebene: Claude Code, Codex, Cursor, Copilot, Windsurf. Die Branche begann, sich auf AGENTS.md: einem Leitfaden auf Repo-Ebene, der dem Agenten die grundlegenden Regeln des Projekts vermittelt.
Doch die Leute fingen an, ihre Claude-Dateien vollzustopfen, und das hatte seinen Preis. Eine Studie der ETH Zürich vom Februar 2026 verglich die Anweisungsdateien aus Repositories mit echten GitHub-Issues und stellte fest, dass überladene Kontextdateien den Erfolg der Aufgaben oft nicht verbesserten und die Inferenzkosten um mehr als 20 % erhöhen konnten.
Es stellt sich heraus, dass der Agent nicht disziplinierter wird, nur weil man dieselbe Anweisung dreimal laut herausschreit. Meistens verschwendet man damit nur Spielmarken und verdeckt die Regeln, auf die es eigentlich ankommt.
Die neue Fehlerart ist „Context Rot“. Ein fehlerhafter AGENTS.md ist schlimmer als gar keine AGENTS.md , da der Agent veraltete Anweisungen dann ohne zu zögern befolgt.
Also hat die Branche das Konzept in zwei Teile aufgeteilt. AGENTS.md sollte schlank bleiben. Es beantwortet die Frage: Welche Regeln und Konventionen gelten speziell für dieses Projekt?
Für alles andere gibt es „Skills“. Ein „Skill“ ist eine bedarfsgesteuerte Referenz für eine bestimmte Aufgabe: wie man einen neuen API-Endpunkt hinzufügt, wie man eine Datenbankmigration durchführt oder wie man eine Release-Checkliste erstellt. Der „Skill“ wird nur geladen, wenn der Agent das Muster erkennt und ihn benötigt.
In der Praxis sieht das so aus:
Ihre AGENTS.md lautet:
Tests ausführen mit npm testaus. Überprüfen Sie den Code immer vor dem Zusammenführen. Verwenden Sie den Webhook-Skill, wenn Sie neue Integrationen hinzufügen.
Der Webhook-Skill sagt:
Erstelle die Route, füge Typen hinzu, schreibe den Handler, behandle Erfolgs- und Fehlerfälle und aktualisiere die Dokumentation.
Der Agent muss nicht jeden Vorgang in einem „Always-On“-Kontext ausführen. Er verbleibt im Skill. Ihre AGENTS.md bleibt übersichtlich. Und sollte sich die Webhook-Prozedur ändern, aktualisieren Sie den Skill nur einmal.
Die Faustregel: Halten Sie AGENTS.md langweilig und kurz. Erstellen Sie eine Skill, wenn Sie einen wiederkehrenden Vorgang haben, den Sie immer wieder erklären müssen. Und behandeln Sie Repo-Anweisungen wie Code: Überprüfen Sie sie, löschen Sie veraltete Regeln und lassen Sie sie nicht veralten.
Das Model Context Protocol (MCP) war im Jahr 2025 wahrscheinlich der Begriff, um den in der Entwicklerwelt am meisten Wirbel gemacht wurde. Die Idee war solide: eine standardisierte Methode, um Integrationen einzubinden, anstatt für jedes Tool eigenen Glue-Code zu schreiben.
Also heißt es 2026 natürlich: „MCP ist tot“. Das stimmt nicht. Aber die Verwendung von MCP ist differenzierter geworden.
Ein von mir befragter CTO brachte es auf den Punkt:
„Die Models stützen sich kaum noch auf MCP. Sie sind mittlerweile erschreckend gut darin geworden, nur noch die Befehlszeile zu nutzen.“
Das Kernproblem ist der Overhead. Ein Standard-MCP-Server kann eine Menge Tool-Schemas in den Kontext ausgeben, bevor der Agent überhaupt etwas Sinnvolles tut. CLI-Tools sind lokal, kombinierbar, und die Modelle eignen sich bereits sehr gut für Unix-ähnliche Arbeitsabläufe: Befehle, Flags, Pipes, JSON-Ausgabe, Protokolle.
Aber Agenten entdecken CLIs nicht einfach so. Sie brauchen Anweisungen, nur etwas weniger detaillierte.
Wenn es sich um eine bekannte Befehlszeilenschnittstelle wie aws, gh, gcloudoder Docker– der Agent kennt es wahrscheinlich bereits aus dem Training. Sie können ihm mitteilen: „Dieses Projekt verwendet die AWS-CLI. Du hast Anmeldedaten. Verwende sie für die Infrastruktur.“ Und den Rest regelt der Agent in der Regel von selbst.
Wenn es sich um eine benutzerdefinierte oder interne CLI handelt, verfassen Sie einen Skill. Oft reicht ein Absatz aus, in dem der Befehl, die Flags und die Form der Ausgabe erläutert werden.
Die Frage, die man sich heute im Zusammenhang mit MCP stellen sollte, lautet nicht: „Ist MCP tot?“, sondern: „Welche Berechtigungen hast du gerade einem Aufrufer eines probabilistischen Tools erteilt?“
MCP ist sinnvoll, wenn der Agent einen kontrollierten Zugriff auf externe Systeme benötigt: Dokumente, Tickets, Observability, Datenbanken, APIs. Wenn jedoch eine CLI diese Aufgabe sicher erledigen kann, sollten Sie damit beginnen. Wenn sich derselbe CLI-Vorgang wiederholt, wandeln Sie ihn in eine „Skill“ um. Greifen Sie auf MCP zurück, wenn keine der beiden Optionen ausreicht, und behandeln Sie jeden MCP-Server wie Produktionsinfrastruktur: Prinzip der geringsten Berechtigungen, Genehmigungen, Protokollierung und Sicherheitsüberprüfung.
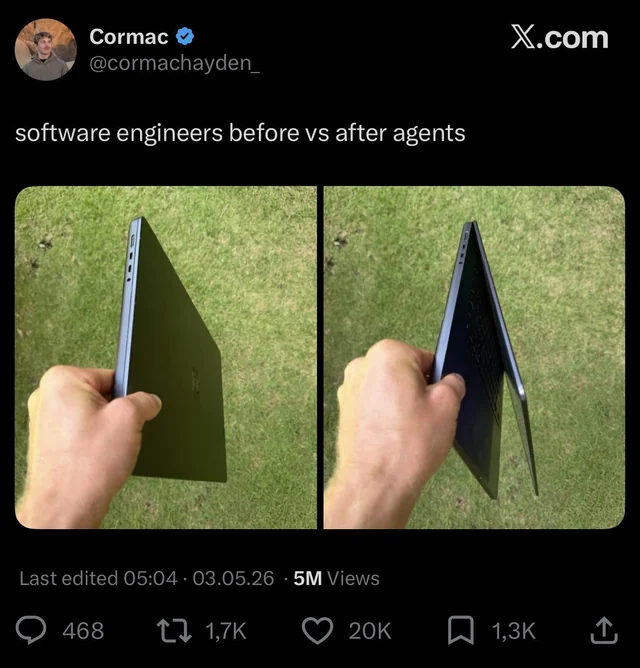 A popular meme highlighting how AI agents have changed the day-to-day experience of software engineering, often shifting the role from implementation toward orchestration and oversight.
Die größere Veränderung im Jahr 2026 besteht darin, dass Programmier-Agenten nicht mehr nur Chatfenster sind, die an einen Editor angehängt sind. Sie entwickeln sich zu Steuerungsebenen.
Claude Code hat /Ziel, Hooks, Subagenten, Hintergrundsitzungen und Agentenansichten. Codex bietet CLI, Cloud, App, Worktrees, Code-Review und mobile Überwachung. GitHub Copilot kann Issues in Pull-Requests umwandeln und Code überprüfen. Google Antigravity ist auf die Verwaltung von Agenten über verschiedene Arbeitsbereiche hinweg ausgelegt.
Die Benutzeroberfläche wandelt sich von „Chat mit einem Model“ hin zu „Verwaltung einer Warteschlange von halbwegs vertrauenswürdigen Mitarbeitern“.
Das klingt futuristisch, aber die praktische Erkenntnis ist langweilig: Jeder Akteur braucht eine klare Aufgabe, einen kleinen Wirkungsbereich, eine Möglichkeit, den Erfolg nachzuweisen, und einen Menschen, der die Verantwortung für die Zusammenführung trägt.
Hier kommen lang laufende Agenten ins Spiel.
Stellen Sie sich vor, Sie hätten eine Liste mit 30 Abhängigkeiten, die aktualisiert werden müssen. Normalerweise würden Sie sich mit dem Agenten zusammensetzen, ihn nach jeder einzelnen fragen, jede Änderung prüfen und jede Zusammenführung genehmigen. Das dauert Stunden und bindet Sie stark.
Ein langfristig laufender Agent kann die Liste der nacheinander abarbeiten: eine Abhängigkeit aktualisieren, Tests ausführen, Fehler beheben, zur nächsten übergehen und den Vorgang beenden, sobald alle Tests erfolgreich abgeschlossen sind.
Das ist ein gutes Anwendungsbeispiel, da „fertig“ objektiv überprüfbar ist.
Beispiele, bei denen lang laufende Agenten tatsächlich sinnvoll sind: Aktualisierung von Abhängigkeiten, Bereinigung von Testumgebungen, Erstellung von Dokumentationen, SDK-Beispiele, Forschungsaufgaben oder Backlog-Elemente mit glasklaren Akzeptanzkriterien wie „alle Tests bestanden“, „Lint-Prüfung bestanden“ oder „Migration abgeschlossen“.
Wenn sie spektakulär scheitern: Abrechnung, Authentifizierung, Berechtigungen, Migrationen, Löschungen, Compliance oder alles, was mit Kundendaten oder deren Lebenszyklus zu tun hat. Hier ist Urteilsvermögen gefragt. „Ist diese Migration sicher?“ ist keine Ja-oder-Nein-Frage. Genauso wenig wie „Sollten wir das löschen?“
Die Regel: Setze lang laufende Agenten nur für Aufgaben ein, bei denen „fertig“ objektiv überprüfbar ist und die Auswirkungen im Falle eines Fehlers gering sind. Alles andere bleibt im menschlichen Tempo.
Wenn Sie Agenten selbst betreiben, ist „tmux“ ist nach wie vor der altbewährte Trick, der dir weiterhilft. Lang laufende Agenten werden beendet, wenn deine SSH-Verbindung unterbrochen wird. Ein Terminal-Multiplexer hält die Sitzung aufrecht, übersteht Verbindungsabbrüche und bietet dir einen Rückblick auf das Geschehene.
Aber tmux ist die DIY-Notlösung, nicht das Hauptthema. Der eigentliche Trend besteht darin, dass die Tools dieses Muster in Produkte umsetzen: Hintergrundsitzungen, Agent-Dashboards, isolierte Arbeitsverzeichnisse, Remote-Freigaben und Review-Warteschlangen.
Persistente Agenten ohne überprüfbare Erfolgskriterien sind nichts anderes als längere, teurere Halluzinationen.
Daneben gibt es eine parallele Kategorie von ständig aktiven Laufzeitumgebungen für persönliche Agenten wie OpenClaw und Hermes. Sie sind als Steuerungsebenen rund um die Programmierarbeit interessant: zum Weiterleiten von Nachrichten, Überwachen von Sitzungen, Versenden von Warnmeldungen und möglicherweise zum Verteilen von Aufgaben. Sie bilden jedoch noch nicht den Kern des Programmier-Workflows. Es lohnt sich, sie im Auge zu behalten und damit zu experimentieren, aber man sollte nicht den Eindruck gewinnen, dass die ganze Welt über einen eigenen OpenClaw-Agenten verfügt. Keiner der 15 Early Adopters, die ich befragt habe, hatte einen eingerichtet.
Die erste Frage, die mir ein leitender KI-Forschungsmanager stellte, als ich meinen Arbeitsablauf ansprach, bezog sich nicht auf Tools oder Frameworks. Sie lautete:
„Wie hoch ist dein Budget für Spielmarken?“
Das ist es, was Ingenieurwesen vom Programmieren unterscheidet. Sicher, bei KI-Agenten kann man ein Problem wahrscheinlich lösen, wenn man genug Geld und Zeit hineinsteckt. Daher hängt nun jede Entscheidung zum Arbeitsablauf weitgehend vom Budget ab. Und verschiedene Agenten wirken sich auf das Budget aus.
Einige meiner Gesprächspartner setzen voll und ganz auf Codex. Andere bevorzugen Claude. Cursor-Nutzer schätzen es, dass sie zwischen verschiedenen Modellen wechseln können. Manche nutzen Copilot, weil es von ihrem Unternehmen bereitgestellt wird.
Ein Gründer erzählte mir, er würde mit Codex „Funktionen wie ein Tier auf einen Schlag umsetzen“. Ein anderer äußerte sich differenzierter:
„Codex ist bei allem, was mit Rechenaufgaben zu tun hat, wahnsinnig gut. Claude hat aber immer noch den besseren Geschmack.“
Doch der besonnene Rat eines CTOs war hilfreicher:
„Lass dich nicht auf ein bestimmtes Modell festlegen. Alle zwei Wochen wird eines schlechter, und ein anderes ist besser.“
Ein bewährtes Prinzip ist die Modellhygiene: Verwenden Sie ein robustes Modell für die Planung und fundierte Argumentation, einfachere Modelle für unkomplizierte Änderungen, ein zweites Modell für die Überprüfung risikoreicher Bereiche sowie übertragbare Anweisungen, damit ein anderes Modell oder eine andere Sitzung die Arbeit fortsetzen kann.
Dies gewinnt umso mehr an Bedeutung, je mehr sich die Preisgestaltung in Richtung einer nutzungsabhängigen Abrechnung entwickelt. Der erfolgreiche Arbeitsablauf besteht nicht darin, „für alles das ausgefeilteste Modell zu verwenden“, sondern darin, zu wissen, wann sich der Aufwand für aufwendige Berechnungen lohnt.
Wenn Code billig wird, wird es teuer, zu überprüfen, ob er funktioniert und gut ist. Das ist kein Argument gegen den Einsatz von KI beim Programmieren. Es ist ein Argument dagegen, Code zu veröffentlichen, den man nicht erklären kann.
Glücklicherweise holen die Tools langsam auf. Hooks sind deterministische Skripte, die bei Agentenereignissen ausgelöst werden. Diese ermöglichen es Teams, bestimmte Überprüfungen zwingend vorzuschreiben. Ein PostToolUse Hook kann nach jeder Dateiänderung automatisch Lint- oder Typüberprüfungen ausführen und so Probleme bereits während der Ausführung statt erst am Ende erkennen. Ein „Stop“ -Hook kann verhindern, dass der Agent den Vorgang vorzeitig als erfolgreich abschließt. Dies sind Sicherheitsvorkehrungen, die nicht vom Urteil des Modells abhängen, und bei lang andauernden oder autonomen Aufgaben ist dieser Unterschied von Bedeutung.
Ein guter Überprüfungszyklus könnte etwa so aussehen:
Der Mitarbeiter soll Tests erstellen oder aktualisieren.
Lassen Sie den Agenten die entsprechende Testsuite ausführen.
Verwenden Sie ein zweites Modell, um wichtige Unterschiede aus der Perspektive des „Red Teams“ zu analysieren.
Risikoreiche Pfade manuell testen.
Ein nützlicher Hinweis vor der Überprüfung durch einen Menschen:
Überprüfen Sie Ihre eigenen Änderungen.
Suchen Sie nach möglichen Fehlern, fehlenden Tests, Randfällen, Sicherheitsbedenken oder unnötiger Komplexität.
Ändern Sie die Dateien noch nicht. Melden Sie zunächst Ihre Ergebnisse.
Die Sicherheitsaspekte sind dabei sogar noch wichtiger. Sobald Agenten Pull-Requests kommentieren, Workflows ausführen, Tools aufrufen und auf Zugangsdaten zugreifen können, ist die Eingabe von Befehlen kein Problem mehr, das nur den Chatbot betrifft, sondern wird zu einem CI/CD-Problem.
Das ist der Punkt, den meiner Meinung nach viele Teams immer noch unterschätzen. Wenn der Agent ein Issue, eine PR-Beschreibung, einen Code-Kommentar oder ein Changelog zu Abhängigkeiten ausliest, handelt es sich dabei um das Auslesen nicht vertrauenswürdiger Eingaben. Verfügt er zudem über die Berechtigung, Befehle auszuführen oder auf Geheimnisse zuzugreifen, entsteht eine Angriffsfläche.
Umso wichtiger sind daher die langweiligen Regeln: Prinzip der geringsten Berechtigungen, Sandboxing, Genehmigungen, kleine Änderungen, deterministische Prüfungen, Audit-Protokolle und persönliche Verantwortung.
Erstellen Sie ein Lean- AGENTS.md mit Befehlen für Installation, Test und Typüberprüfung, Workflow-Regeln und einer Definition von „Fertig“. Halten Sie die Datei kurz. Fügen Sie Regeln erst dann hinzu, wenn der Agent tatsächlich bei etwas versagt, und nicht vorsorglich.
Für nicht-triviale Aufgaben ist eine sorgfältige Planung erforderlich. Vor dem Programmieren erstellt der Agent einen Plan in Form einer Checkliste für tasks/todo.md , in der das Ziel, relevante Dateien, Schritte und Risiken aufgeführt sind.
Archivieren Sie abgeschlossene Pläne unter tasks/archive/. Diese bilden die Historie dessen, was der Agent zu tun glaubte und warum.
Eine Aufgabe pro Prompt, ein Problem pro Diff. Kleine Diffs lassen sich leicht überprüfen. Große Diffs verbergen Fehler.
Keine Verhaltensänderung kommt ohne Test aus. Wenn der Mitarbeiter sagt: „Es ist kein Test erforderlich“, sollten Sie nachhaken.
Schreibe beim dritten Mal, wenn du etwas erklärst, eine „Skill“-Datei. Wenn du dem Agenten zum ersten Mal einen Vorgang erklärst, beschreibe ihn einfach nur. Beim zweiten Mal achte auf die Wiederholung. Beim dritten Mal schreibe eine „SKILL.md“-Datei.
Standardmäßig wird die CLI verwendet. Fügen Sie MCP nur hinzu, wenn der Agent einen kontrollierten Zugriff auf ein externes System benötigt und der CLI-Pfad nicht ausreicht.
Verwenden Sie lang laufende Agenten nur für Aufgaben, bei denen „fertig“ objektiv überprüfbar ist. Aktualisierungen von Abhängigkeiten, Bereinigung von Tests, Dokumentation, Lint-Korrekturen? Gerne. Abrechnung, Authentifizierung, Migrationen, Löschvorgänge? Nein.
Prüfen Sie risikoreiche Änderungen des Red-Teams mit einem zweiten Modell. Bevor Sie Änderungen zusammenführen, die die Sicherheit, den Zahlungsverkehr, Berechtigungen oder den Datenlebenszyklus betreffen, lassen Sie diese von einem anderen Modell auf Probleme überprüfen.
Übernehmen Sie den menschlichen Teil. Prüfen Sie die Änderungen selbst. Starten Sie die App. Testen Sie die risikobehafteten Pfade manuell. Der Agent macht Vorschläge. Sie entscheiden.
Diese Recherche hat mich beruhigt. Die Best Practices sind letztlich nur verschiedene Varianten dessen, was schon immer galt: Halte dich an die SOLID-Prinzipien, setze auf TDD und erstelle detaillierte Spezifikationen, bevor du mit der Entwicklung beginnst.
Der beste KI-basierte Programmier-Workflow ist kein Ersatz für Softwareentwicklung. Es handelt sich vielmehr um Softwareentwicklung mit einem viel schnelleren Nachwuchsentwickler, der niemals müde wird, manchmal Halluzinationen hat, gelegentlich alles kaputtmacht und sehr klare Anweisungen benötigt.
Wenn man es so betrachtet, sind diese Werkzeuge unglaublich. Betrachtet man es jedoch als Zauberei, muss man irgendwann diese Zauberei debuggen.
Das ist mein erster Versuch, den Rückstand aufzuholen. Jetzt möchte ich von Leuten hören, die tatsächlich mit diesen Tools arbeiten. Wie sieht euer Arbeitsablauf beim Programmieren von KI derzeit aus?
Verwendest du Cursor, Claude Code, Codex, Copilot oder etwas anderes? Hast du es schon einmal mit Skills, MCP, Subagenten, Worktrees, /goal, Hooks oder Langzeit-Agenten ausprobiert? Was hat nicht funktioniert? Was hast du wieder aufgegeben?
Bitte teile mir dies in diesem LinkedIn-Beitrag.
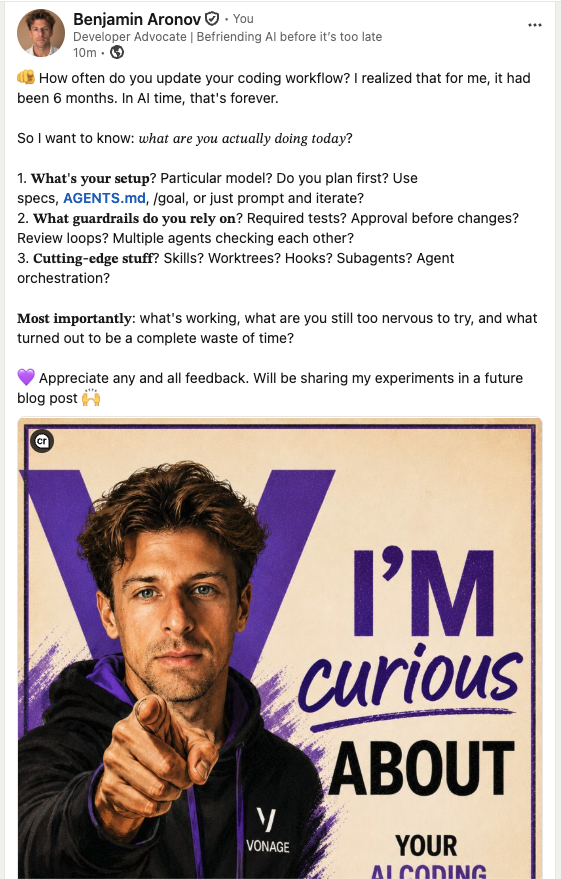 A LinkedIn post asking developers how their AI coding workflows have evolved in 2026, including questions about planning, guardrails, and emerging agentic practices.Ich werde die besten Antworten nutzen, um einen Folgebeitrag zu verfassen, in dem ich die wichtigsten Arbeitsabläufe anhand realer Vonage-API-Projekte teste: parallele Agenten, „Spec-First“-Planung, Lean AGENTS.md sowie Skills, MCP vs. CLI und Verifizierungsschleifen, die echte Fehler aufspüren.
Die Ergebnisse werde ich im nächsten Beitrag vorstellen.
Haben Sie eine Frage oder möchten Sie uns mitteilen, was Sie gerade bauen?
Abonnieren Sie den Entwickler-Newsletter
Folgen Sie uns auf X (früher Twitter) für Updates
Sehen Sie sich die Tutorials auf unserem YouTube-Kanal
Verbinden Sie sich mit uns auf der Vonage Entwickler-Seite auf LinkedIn
Helfen Sie uns, unsere Entwicklererfahrung zu verbessern, indem Sie unser Feedback-Formular „Voice of the Developer“ aus.
Bleiben Sie auf dem Laufenden und halten Sie sich über die neuesten Nachrichten, Tipps und Veranstaltungen für Entwickler auf dem Laufenden.
Teilen Sie:
Benjamin Aronov ist ein Entwickler-Befürworter bei Vonage. Er ist ein bewährter Community Builder mit einem Hintergrund in Ruby on Rails. Benjamin genießt die Strände von Tel Aviv, das er sein Zuhause nennt. Von Tel Aviv aus kann er einige der besten Startup-Gründer der Welt treffen und von ihnen lernen. Außerhalb der Tech-Branche reist Benjamin gerne um die Welt auf der Suche nach dem perfekten Pain au Chocolat.