Compartilhar:
Nimrod é cientista de dados na Vonage, com quase 10 anos de experiência no setor de aprendizado de máquina e inteligência artificial. É físico de formação e tem trabalhado na aplicação de aprendizado de máquina e IA a uma variedade de problemas práticos. Seu trabalho inclui o desenvolvimento de soluções baseadas em dados e a exploração do uso de tecnologias emergentes de IA, incluindo grandes modelos de linguagem.
O imposto oculto sobre tokens nos esquemas JSON
A saída estruturada tornou-se uma das formas mais seguras de integrar grandes modelos de linguagem (LLMs) em sistemas de produção. Você passa um esquema JSON para a chamada da API do LLM, e a resposta tem a garantia de estar em conformidade com essa estrutura. Sem falhas de análise, sem respostas malformadas, sem lógica de repetição de tentativas.
Os esquemas JSON aumentam o uso de tokens de entrada, pois o esquema é incluído em todas as solicitações enviadas ao modelo. Dependendo do provedor, essa sobrecarga varia de quase insignificante a mais de dez vezes o tamanho original do prompt.
Neste artigo, você verá medições em vários modelos e aprenderá como reduzir essa sobrecarga.
Uma breve introdução para quem não está tão familiarizado com o faturamento de LLM: os modelos de linguagem processam o texto como tokens — fragmentos de palavras, com cerca de 3 a 4 caracteres cada. Você paga por token, tanto pelo que envia (tokens de entrada) quanto pelo que recebe de volta (tokens de saída). Quando algo adiciona tokens silenciosamente à sua chamada de API, isso é adicionado diretamente à sua fatura.
O Centro de Excelência em IA (CoE) da Vonage adotou a saída estruturada em todos os nossos fluxos de trabalho — análise de sentimento, extração de entidades e avaliação de interações com o cliente. A melhoria na experiência dos desenvolvedores foi imediata.
Durante os testes, no entanto, percebemos um padrão inesperado. Nosso uso de tokens era consistentemente maior do que o que nossos prompts, por si só, deveriam ter gerado — não o suficiente para acionar um alerta, mas o suficiente para ser percebido. Estávamos executando prompts analíticos curtos, talvez com cerca de 100 tokens cada, em modelos com esquemas JSON anexados. O tamanho dos prompts era insignificante; então, de onde vinham os tokens extras? Montamos um experimento para descobrir.
A documentação sobre saída estruturada explica como usá-la, mas não informa quanto custa. Cada provedor possui uma página intitulada “Saída Estruturada” que explica os parâmetros da API. Nenhum deles explica o que acontece com sua contagem de tokens quando você anexa um esquema.
Queríamos responder a uma pergunta simples: quando você passa um esquema JSON para um LLM, quantos tokens de entrada a mais isso realmente acrescenta?
A configuração foi deliberadamente minimalista. O mesmo prompt, a mesma instrução do sistema, a mesma temperatura. A única variável era se havia um esquema anexado e qual era o grau de complexidade desse esquema.
Testamos cinco esquemas, que variaram de extremamente simples a adequados para ambiente de produção. O Esquema consistia em apenas um único campo (88 caracteres de JSON):
{
  "type": "object",
  "properties": {
    "answer": { "type": "string" }
  },
  "required": ["answer"]
} A partir daí, aumentamos o nível de complexidade:
Simples - três campos com uma restrição de enumeração (237 caracteres)
Médio - um objeto aninhado com matrizes (358 caracteres)
Complexo - matrizes de objetos com enums (555 caracteres)
Muito complexo - aninhamento profundo, múltiplas matrizes, valores booleanos, enumerações (1.730 caracteres)
O prompt em si consistia em uma breve interação de atendimento ao cliente que consumiu cerca de 99 tokens no tokenizador do Gemini e 121 no do Claude. Tokenizadores diferentes dividem o mesmo texto de maneiras distintas, o que explica a diferença inicial entre os provedores. Criamos o prompt deliberadamente curto porque queríamos observar a sobrecarga isoladamente, sem que ela ficasse oculta em um contexto extenso.
Testamos o programa em três modelos: Gemini 2.5 Flash, Gemini 3.5 Flash e Claude Haiku 4.5.
O gráfico abaixo mostra o total de tokens de entrada relatados por cada modelo nos cinco níveis de complexidade de esquema. As barras cinzas de referência representam o mesmo prompt enviado sem nenhum esquema anexado.
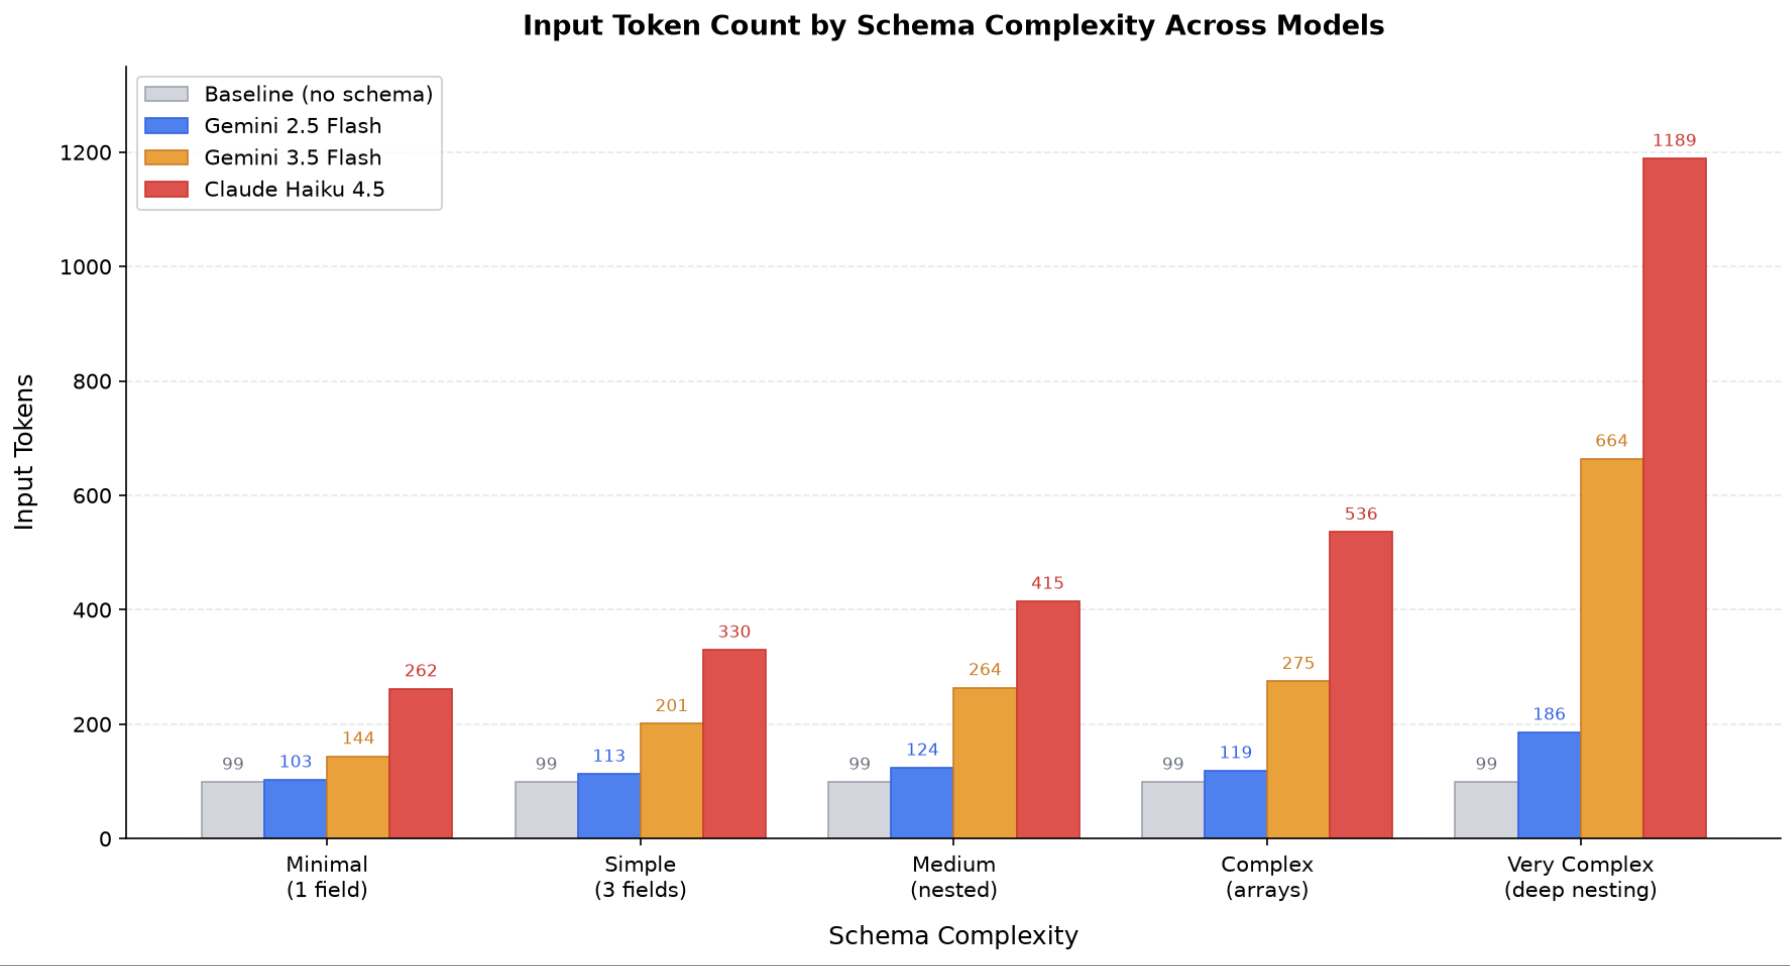 Os resultados mostram um padrão claro. Como esperado, o aumento da complexidade resulta em maior consumo de tokens nos três modelos. Mas há um que se destaca claramente: o Gemini 2.5 Flash permanece próximo da linha de base durante todo o processo. Para o esquema profundamente aninhado, o Gemini 2.5 Flash usa 186 tokens, em comparação com os 1.189 do Claude Haiku 4.5.
A contabilidade de tokens varia ligeiramente entre os provedores; portanto, essas métricas refletem os tokens de faturamento declarados, e não os detalhes internos da implementação.
Pois, individualmente, os tokens são baratos. Mas o panorama de custos muda dependendo do seu caso de uso.
Se você estiver processando saídas estruturadas em documentos longos — digamos, entradas com mais de 5.000 tokens —, a sobrecarga é insignificante. Algumas centenas de tokens a mais além dos 5.000 são um erro de arredondamento.
Mas a maioria das chamadas de saída estruturada em produção não envolve contexto extenso. São tarefas analíticas curtas:
Classifique esta mensagem do cliente (sentimento, intenção, urgência)
Extraia as entidades desta frase
Avalie essa interação em cinco dimensões
Encaminhe este ticket para o departamento correto
Essas instruções costumam ter entre 50 e 500 tokens. Nessa escala, a sobrecarga passa a ser o principal fator que contribui para o custo total dos tokens de entrada.
Considere um esquema de complexidade média no Claude Haiku 4.5 com um prompt de 100 tokens:
Sem esquema: 121 tokens de entrada
Com o esquema: 415 tokens de entrada
Despesas gerais: 71% do valor total da sua fatura de insumos
Você está pagando quase 3,5 vezes mais em tokens de entrada do que o seu conteúdo realmente justifica. Se considerarmos isso em milhões de chamadas de API por mês, isso se torna um fator de custo significativo.
É aqui que a coisa fica interessante para quem está avaliando modelos para cargas de trabalho de produção.
Com uma carga útil de 100 tokens e um esquema médio:
Modelo | Contribuição eficaz | Preço por M tokens | Custo por 1 milhão de chamadas |
Gemini 2.5 Flash | 124 fichas | $0,30 | $37,20 |
Gemini 3.5 Flash | 264 fichas | $1,50 | $396,00 |
Claude Haiku 4.5 | 415 fichas | $0,80 | $332,00 |
Preços válidos a partir de julho de 2026
O Gemini 2.5 Flash é cerca de nove vezes mais barato que o Claude Haiku e onze vezes mais barato que o Gemini 3.5 Flash para esse caso de uso específico. Não apenas por causa do preço base, mas devido à forma como cada modelo lida com o esquema internamente.
As relações de preço-base (o Haiku é 2,7 vezes mais caro que o 2,5 Flash por token) são amplificadas pelos custos adicionais, resultando em diferenças de custo efetivo muito maiores.
A sobrecarga é um custo fixo por chamada. À medida que a carga útil da sua chamada aumenta, ela vai diminuindo:
Com 500 tokens (uma mensagem curta do cliente com contexto), o esquema médio apresenta um aumento de 37% no Haiku
A partir de 2.000 tokens (uma transcrição completa da conversa) — redução para 13%
Com 5.000 tokens (um resumo de documento ou trecho de contexto RAG) — menos de 6%
A partir de 10.000 tokens (um documento longo ou um histórico com várias rodadas) — aproximadamente 3%
Se sua carga de trabalho envolver resumir documentos, aplicar o RAG a trechos recuperados ou analisar transcrições completas de conversas, a sobrecarga é realmente insignificante. Essa é uma preocupação principalmente para cargas de trabalho de alto volume com prompts curtos, como classificação, roteamento e extração de entidades.
Quando você passa um esquema JSON pela API, os modelos o processam basicamente de duas maneiras:
Codificação compacta - o esquema é processado de forma eficiente, possivelmente como tokens especiais ou uma instrução compactada. O Gemini 2.5 Flash parece codificar esquemas dessa maneira. A sobrecarga é mínima e varia proporcionalmente ao tamanho do esquema.
Expansão detalhada - o esquema é convertido em instruções em linguagem natural que especificam explicitamente cada restrição. É isso que as contagens de tokens sugerem que o Gemini 3.5 Flash e o Claude Haiku estão fazendo, e isso explica por que sua sobrecarga varia de forma aproximadamente linear com o número de caracteres do esquema.
A abordagem detalhada provavelmente garante uma conformidade mais confiável com o esquema para estruturas complexas, mas acarreta um custo simbólico que nenhum provedor documenta.
Veja como reduzir isso:
Mantenha os esquemas o mais simples possível. Remova campos que você não usa no seu código de processamento posterior. Simplifique estruturas aninhadas quando a hierarquia não for semanticamente necessária. Coloque descrições e exemplos no seu prompt, não na própria definição do esquema. Um esquema reduzido de 1.730 caracteres para 555 economiza cerca de 650 tokens por chamada no Claude.
No Claude, a sobrecarga do esquema varia de 0,6 a 1,6 tokens extras por caractere do JSON do esquema, sendo que esquemas menores apresentam uma sobrecarga proporcionalmente maior. No Gemini 3.5 Flash, ela é menor — cerca de 0,3 a 0,5 tokens por caractere —, mas ainda assim se acumula com o volume.Adapte o modelo à forma da carga de trabalho. Se sua carga de trabalho de produção consistir principalmente em saídas estruturadas com prompts curtos (menos de 500 tokens de conteúdo real), a sobrecarga deve ser levada em conta nos critérios de seleção do modelo. Se suas entradas forem longas (mais de 2.000 tokens), a sobrecarga é insignificante. Nesse caso, opte pela qualidade e pela latência.
Considere não usar o esquema em casos simples. Para um único rótulo de classificação ou um sinalizador booleano, um prompt bem elaborado que solicite JSON diretamente não gera nenhum custo adicional. Você troca um pouco de confiabilidade por economia de custos — o que vale a pena quando a estrutura é simples.
Agrupe as tarefas sempre que possível. A sobrecarga é um custo fixo por chamada. Processar 10 itens em uma única chamada significa pagar esse custo uma vez, em vez de dez vezes.
Meça isso. Execute a mesma chamada com e sem o esquema. A diferença nos tokens de entrada é o seu custo oculto. Multiplique pelo volume de chamadas e pelo preço por token. Esse número deve constar no seu modelo de custos.
A sobrecarga de esquema é um custo que não aparece como um item separado na sua fatura. Para equipes que executam milhões de chamadas de saída estruturada com prompts curtos, ela pode representar a maior parte dos gastos com tokens de entrada. Medir a sobrecarga de esquema e levá-la em consideração durante a seleção do modelo é o primeiro passo para reduzir custos desnecessários com IA.
Os experimentos descritos neste artigo utilizaram prompts idênticos em todos os modelos e condições:
Modelos Gemini foram testados por meio da API REST do Vertex AI (us-central1 para o 2.5 Flash, global para o 3.5 Flash)
Claude Haiku 4.5 foi testado por meio do AWS Bedrock
A temperatura foi definida como 0,0 em todas as execuções
Foram testados cinco níveis de complexidade de esquema, cada um deles executado tanto no modo de controle (sem esquema) quanto no modo com esquema
As contagens de tokens são as informadas pela API de uso de cada provedor
Tem alguma dúvida ou quer compartilhar o que está criando?
Inscreva-se no Boletim Informativo para Desenvolvedores
Siga-nos no X (antigo Twitter) para ficar por dentro das novidades
Assista aos tutoriais no nosso canal do YouTube
Conecte-se conosco na página de desenvolvedores da Vonage no LinkedIn
Fique conectado e acompanhe as últimas notícias, dicas e eventos para desenvolvedores.
Compartilhar:
Nimrod é cientista de dados na Vonage, com quase 10 anos de experiência no setor de aprendizado de máquina e inteligência artificial. É físico de formação e tem trabalhado na aplicação de aprendizado de máquina e IA a uma variedade de problemas práticos. Seu trabalho inclui o desenvolvimento de soluções baseadas em dados e a exploração do uso de tecnologias emergentes de IA, incluindo grandes modelos de linguagem.