シェア:
Nimrod is a Data Scientist at Vonage, with nearly 10 years of industry experience in machine learning and artificial intelligence. He is a physicist by training and has worked on applying machine learning and AI to a range of practical problems. His work includes developing data-driven solutions and exploring the use of emerging AI technologies, including large language models.
JSONスキーマに潜む「トークン税」
構造化出力は、大規模言語モデル(LLM)を本番システムに統合するための最も安全な方法の一つとなっています。LLM API呼び出しにJSONスキーマを渡せば、レスポンスがその構造に確実に準拠します。解析エラーも、形式不備のレスポンスも、再試行ロジックも発生しません。
JSONスキーマは、モデルに送信されるすべてのリクエストにスキーマが含まれるため、入力トークンの使用量を増やします。プロバイダーによっては、このオーバーヘッドは、ほとんど無視できる程度から、元のプロンプトサイズの10倍以上までさまざまです。
この記事では、複数のモデルにわたる測定結果を確認し、そのオーバーヘッドを削減する方法について学びます。
LLMの課金システムにあまり詳しくない方のために、簡単に説明します。言語モデルはテキストをトークン(単語の断片で、1つあたりおよそ3~4文字)として処理します。 課金はトークン単位で行われ、送信するトークン(入力トークン)と受け取るトークン(出力トークン)の両方が対象となります。API呼び出しの際に、何らかの理由でトークンが自動的に追加されると、その分が直接請求額に上乗せされます。
VonageのAIセンター・オブ・エクセレンス(CoE)では、センチメント分析、エンティティ抽出、顧客対応評価といった各パイプライン全体で構造化出力を導入しました。その結果、開発者の体験は即座に向上しました。
しかし、テスト中に予期せぬ傾向に気づきました。トークンの使用量が、プロンプトだけで発生するはずの量よりも一貫して多かったのです。アラートがトリガーされるほどではありませんが、気づくには十分な量でした。 私たちは、JSONスキーマが添付されたモデルに対して、1つあたり100トークン程度の短い分析用プロンプトを実行していました。プロンプトのサイズはごくわずかだったため、余分なトークンは一体どこから発生していたのでしょうか?その原因を突き止めるため、実験を実施しました。
構造化出力のドキュメントにはその使用方法は記載されていますが、コストについては記載されていません。各プロバイダーには、APIパラメータを説明する「構造化出力」ページがあります。しかし、スキーマを添付した場合にトークン数がどのように扱われるかについては、どのプロバイダーのドキュメントにも説明がありません。
私たちは、ある単純な疑問に答えたいと考えました。JSONスキーマをLLMに渡すと、実際にはどれだけの余分な入力トークンが追加されるのでしょうか?
設定は意図的に最小限に抑えました。プロンプトも、システムの指示も、温度も同じにしました。唯一の変数は、スキーマが添付されているかどうか、そしてそのスキーマがどれほど複雑かという点だけでした。
我々は、ごく単純なものから本番環境向けのものまで、5つのスキーマをテストしました。その 最小限の スキーマは、たった1つのフィールド(88文字のJSON)で構成されていました:
{
  "type": "object",
  "properties": {
    "answer": { "type": "string" }
  },
  "required": ["answer"]
} そこから、複雑さを段階的に高めていきました:
シンプル - 列挙型制約のある3つのフィールド(237文字)
中 - 配列を含むネストされたオブジェクト (358文字)
複合 - 列挙型を含むオブジェクトの配列 (555文字)
非常に複雑 - 深いネスト、複数の配列、ブール値、列挙型 (1,730文字)
このプロンプト自体は、Geminiのトークナイザーでは約99トークン、Claudeのトークナイザーでは121トークンを消費する、短いカスタマーサービスでのやり取りでした。トークナイザーが異なると、同じテキストの分割方法も異なるため、これがプロバイダー間のベースラインの差の原因となっています。長いコンテキストの中に埋もれさせずに、オーバーヘッドを単独で確認したかったため、プロンプトを意図的に短くしました。
「Gemini 2.5 Flash」、「Gemini 3.5 Flash」、そして「Claude Haiku 4.5」の3つのモデルで実行しました。
以下のグラフは、5つのスキーマ複雑度レベルすべてにおいて、各モデルが報告した入力トークンの総数を示しています。灰色のベースラインの棒グラフは、スキーマを一切指定せずに送信された同じプロンプトの結果を表しています。
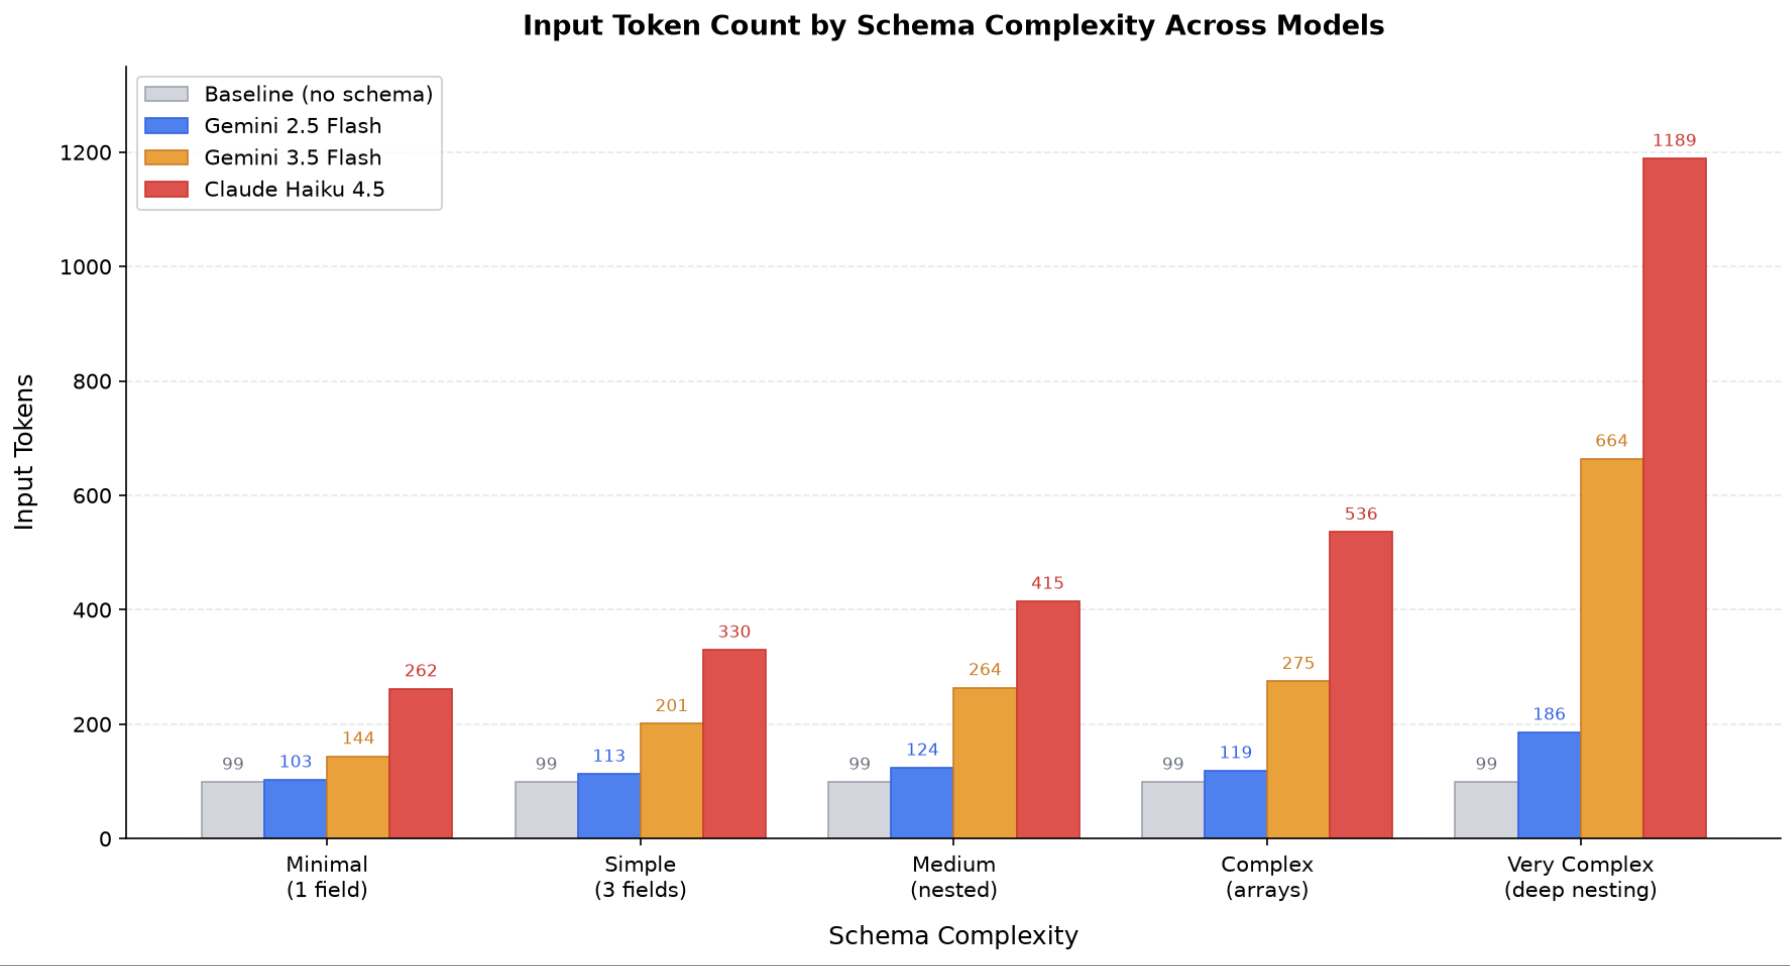 結果からは明確な傾向が見て取れます。予想通り、複雑さが増すにつれて、3つのモデルすべてにおいてトークン消費量が増加しています。しかし、1つだけ際立った特徴があります。それは、Gemini 2.5 Flashが全工程を通じてベースラインに近い数値を維持していることです。 深くネストされたスキーマの場合、Gemini 2.5 Flash のトークン使用数は 186 であるのに対し、Claude Haiku 4.5 は 1,189 となっています。
トークンの集計方法はプロバイダーごとに若干異なるため、これらの数値は内部の実装の詳細ではなく、報告された課金トークンの数を反映したものです。
トークン1つあたりの価格は安いです。しかし、ユースケースによってコストの状況は異なります。
長い文書(たとえば、5,000トークン以上の入力)に対して構造化出力を実行する場合、オーバーヘッドは無視できる程度です。5,000トークンに数百トークンが追加されたとしても、それは丸め誤差に過ぎません。
しかし、本番環境での構造化出力の呼び出しのほとんどは、長時間のコンテキストを必要とするものではありません。それらは、短時間の分析タスクです:
この顧客メッセージを分類してください(感情、意図、緊急度)
この文からエンティティを抽出する
このやり取りを5つの側面から評価してください
このチケットを適切な部署に振り分けてください
これらのプロンプトは通常、50~500トークンです。この規模になると、オーバーヘッドが入力トークンのコストの大部分を占めるようになります。
Claude Haiku 4.5 において、100トークンのプロンプトを用いた中程度の複雑さのスキーマについて考えてみましょう:
スキーマなし:121個の入力トークン
スキーマあり:415個の入力トークン
間接費:総仕入額の71%
実際のコンテンツに見合う額よりも、入力トークンの支払いが3.5倍近く多くなっています。これを月間数百万件のAPI呼び出しに拡大して考えると、これは大きなコスト要因となります。
ここで、本番環境のワークロード向けにモデルを評価している人にとっては、興味深い点が出てきます。
中規模のスキーマで、ペイロードが100トークンの場合:
モデル | 効果的なインプット | 価格/Mトークン | 100万件あたりの通話単価 |
Gemini 2.5 Flash | 124トークン | 0.30ドル | 37.20ドル |
Gemini 3.5 Flash | 264トークン | 1.50ドル | 396.00ドル |
クロード・ハイク 4.5 | 415トークン | 0.80ドル | 332.00ドル |
2026年7月現在の価格
この特定のユースケースにおいて、Gemini 2.5 FlashはClaude Haikuに比べておよそ9分の1、Gemini 3.5 Flashに比べて11分の1のコストで利用できます。これは単に基本価格の違いだけでなく、各モデルが内部でスキーマをどのように処理しているかにも起因しています。
基本価格の比率(Haikuは2.5 Flashに比べてトークンあたり2.7倍高い)は、オーバーヘッドによって増幅され、実質的なコスト差はさらに大きくなります。
オーバーヘッドは、1回の呼び出しあたりの固定コストです。入力ペイロードが大きくなるにつれて、その影響は薄れていきます:
500トークン(文脈を含む短い顧客メッセージ)の場合、ミディアムスキーマではHaiku上で37%の増加が見られます
2,000トークン(会話の全文記録)の場合、13%まで低下
5,000トークン(文書の要約またはRAGコンテキストチャンク)の場合、6%未満
10,000トークン(長文の文書や複数ターンにわたる履歴)の場合、約3%
文書の要約、検索された文章に対するRAGの実行、あるいは会話の全文記録の分析といった処理を行う場合、そのオーバーヘッドは実質的に無視できる程度です。これは主に、分類、ルーティング、エンティティ抽出など、処理量が多く、プロンプトが短いワークロードにおいて懸念される問題です。
API を通じて JSON スキーマを渡した場合、モデルはそれを大きく分けて 2 つの方法で処理します:
コンパクトなエンコーディング - スキーマは、特別なトークンや圧縮された命令として処理されるなど、効率的に処理されます。Gemini 2.5 Flash は、この方法でスキーマをエンコードしているようです。オーバーヘッドは最小限に抑えられ、スキーマのサイズに応じて緩やかに増加します。
詳細な展開 - スキーマは、すべての制約を明示的に記述した自然言語の指示に変換されます。これは、トークン数の分析から、Gemini 3.5 Flash や Claude Haiku が実施していると示唆される処理であり、これらのモデルのオーバーヘッドがスキーマの文字数にほぼ線形に比例する理由を説明しています。
この詳細なアプローチは、複雑な構造においてスキーマへの準拠性をより確実に高める可能性がありますが、その代償としてトークンのコストが発生します。ただし、この点について文書化しているプロバイダーは存在しません。
これを減らす方法は次のとおりです:
スキーマは最小限に抑えてください。 下流のコードで使用しないフィールドは削除してください。意味論的に階層構造が不要な場合は、ネストされた構造をフラット化してください。説明や例は、スキーマ定義自体ではなく、プロンプトに記述してください。1,730文字から555文字に縮小されたスキーマにより、Claudeでの呼び出し1回あたり約650トークンを節約できます。
Claudeでは、スキーマのオーバーヘッドはスキーマJSONの1文字あたり0.6~1.6トークンの追加コストとなり、スキーマが小さいほど相対的にオーバーヘッドが大きくなります。Gemini 3.5 Flashでは、1文字あたり約0.3~0.5トークンと低くなりますが、処理量が増えるとそれでも累積して大きな負担となります。ワークロードの形状に合わせてモデルを選択してください。 本番環境のワークロードが主に短いプロンプトによる構造化された出力(実際のコンテンツが500トークン未満)である場合は、オーバーヘッドをモデル選定の基準の一つに含める必要があります。入力が長い(2,000トークン以上)場合は、オーバーヘッドは無視できる程度です。その場合は、品質とレイテンシを基準に選択してください。
単純なケースでは、スキーマを省略することを検討してください。 単一の分類ラベルやブール値のフラグの場合、JSONを直接要求するように巧妙に作成されたプロンプトであれば、オーバーヘッドはゼロです。信頼性を多少犠牲にする代わりにコストを削減できますが、構造が単純な場合にはそれだけの価値があります。
可能な場合はバッチ処理を行う。 オーバーヘッドは呼び出しごとの固定コストです。1回の呼び出しで10件を処理すれば、10回分ではなく1回分のコストで済みます。
測定してみましょう。 スキーマを指定した場合と指定しない場合で、同じ呼び出しを実行してください。入力トークンの差分が、隠れたコストとなります。これに呼び出し回数とトークン単価を掛け合わせてください。その数値をコストモデルに組み込んでください。
スキーマオーバーヘッドは、請求書上で個別の項目として表示されないコストです。数百万件もの短いプロンプトによる構造化出力呼び出しを実行しているチームの場合、このコストが入力トークンの消費量の大部分を占めることがあります。スキーマオーバーヘッドを測定し、モデル選定の際にこれを考慮に入れることが、不要なAIコストを削減するための第一歩となります。
本記事で述べた実験では、すべてのモデルおよび条件において同一のプロンプトが使用された:
Geminiモデル は、Vertex AI REST API を通じてテストされました(2.5 Flash は us-central1、3.5 Flash は global)。
Claude Haiku 4.5 AWS Bedrock を通じてテストされました
すべての実行において、温度は0.0に設定された
5つのスキーマ複雑度レベルについて検証が行われ、それぞれについて「対照群(スキーマなし)」モードと「スキーマあり」モードの両方で実行された。
トークンの数は、各プロバイダーの利用状況APIによる報告値に基づいています
ご質問がある場合、またはあなたが作っているものを共有したい場合は、こちらをクリックしてください。
登録する 開発者ニュースレター
フォローする X(旧ツイッター)最新情報
Videoの方がいいですか? 当社の YouTubeチャンネルでチュートリアルをご覧ください
LinkedInの LinkedIn の Vonage デベロッパーページ
開発者体験の向上にご協力ください。以下の 「開発者の声」フィードバックにご協力ください
最新の開発者向けニュース、ヒント、イベント情報をお届けします。
シェア:
Nimrod is a Data Scientist at Vonage, with nearly 10 years of industry experience in machine learning and artificial intelligence. He is a physicist by training and has worked on applying machine learning and AI to a range of practical problems. His work includes developing data-driven solutions and exploring the use of emerging AI technologies, including large language models.