シェア:

Javier studied Industrial Engineering back in Madrid where he's from. He is now one of our Solution Engineers, so if you get into trouble using our APIs he may be the one that gives you a hand. Out of work he loves playing football and travelling as much as he can.
Vonage Video APIによるリアルタイム翻訳
所要時間:2 分
進化し続けるデジタル・コミュニケーションにおいて、ビデオ通話のリアルタイム翻訳は、言語の壁を取り除き、グローバルなコラボレーションを促進するために不可欠な要素となっています。Vonage Video API により、開発者はこの革新的な機能をアプリケーションにシームレスに統合することができます。
国境を越えた会議プラットフォームの構築、言語学習アプリの開発、グローバル規模でのカスタマーサポートの強化など、当社のリアルタイム翻訳機能は開発をスピードアップします。このブログポストでは、世界中の視聴者のために包括的でアクセシブルなビデオ体験を作成する方法を学びます。さあ、始めましょう!
始める前に、これから作るものを見てみよう。サンプル・ビデオをご覧ください:
2人のユーザーが異なる言語で話す、より複雑なアプリケーションのデモをご覧になりたい方は、こちらのビデオをご覧ください:
Video API アカウント。クリック サインアップをクリックして作成してください。
Node.jsのインストール エクスペリエンス・コンポーザーAPIをアカウントで有効にします。これは アカウントポータル
Google Cloud Platformのアカウントと、以下のプロジェクトが必要です。 音声合成, 翻訳そして 音声合成APIが有効。
このブログ記事は、Vonage Video APIに精通していることを前提としています。
Googleの自動再生ポリシーによって自動再生オーディオがブロックされないように、ウェブサイトのメディアエンゲージメントを高くする必要があります。詳しくは こちら.テスト目的で デベロッパースイッチ
次の図は、これから作るもののアーキテクチャを示している。手始めに Audio Connector APIを使用して、Video セッションから生の音声データ(PCM 16 Khz/16bit)をセキュアな WebSocket 接続を介してサーバーに送信します。次に、サーバーは Google Cloud との接続を確立し、生のオーディオ データをパイプし、書き起こし、翻訳し、翻訳されたオーディオ データを取得します。
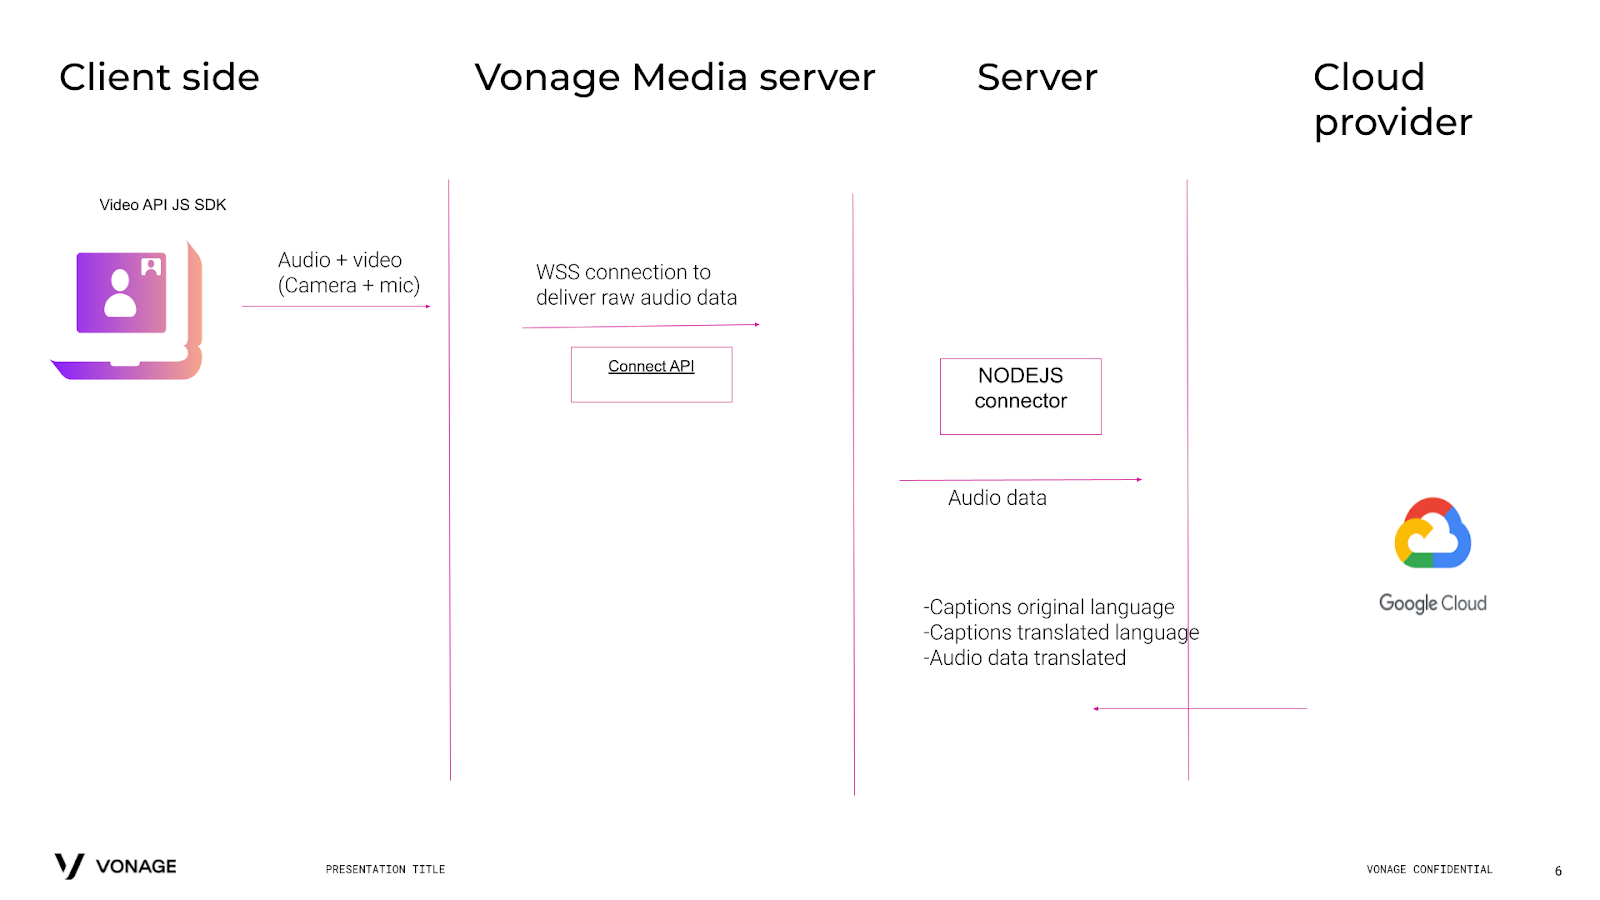 Real-Time Translation Architectual Diagram
キャプションと音声データの翻訳が完了したら、次のように活用できます。 エクスペリエンス コンポーザー APIを活用して Video セッションに音声を注入します。Experience Composer API を使用すると、Web サイトのコンテンツを新しいストリームとして Video API セッションに公開できます。
したがって、サーバーからオーディオを受信し、それを再生するシンプルなウェブページを公開することができます。 ウェブオーディオAPI.このウェブサイトのコンテンツは、Experience Composerの機能によってセッションに公開されているため、通話中のすべてのユーザーが翻訳を聞くことができます。このロジックは次のスクリーンショットで説明します:
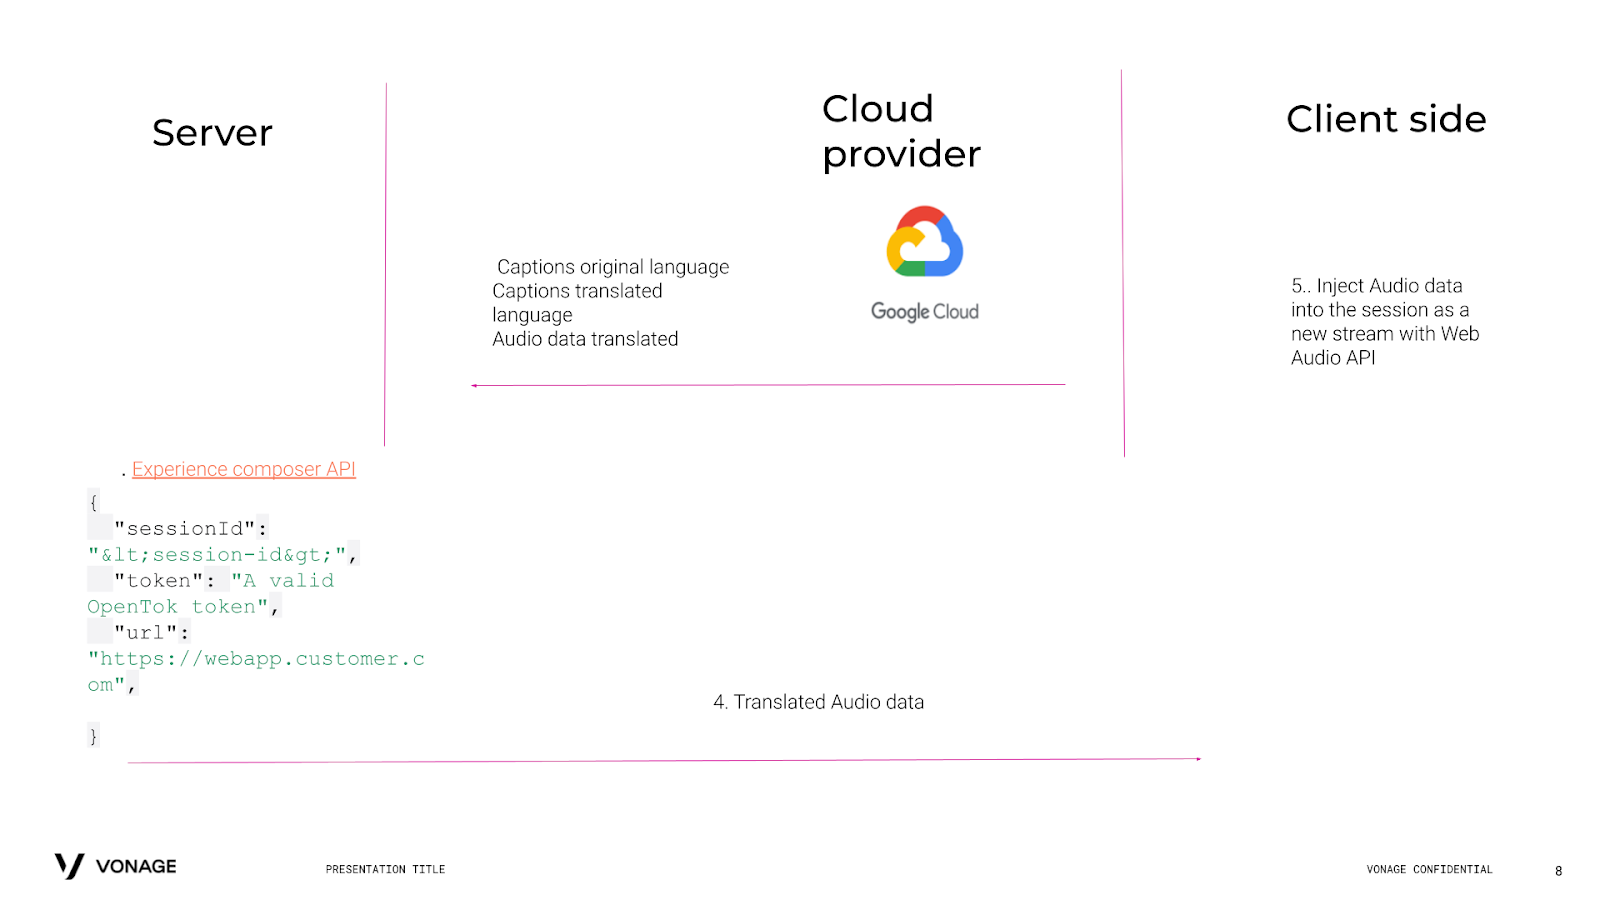 Vonage API Real-Time Translation Logic
なぜ、WebSocket接続ですべてのユーザーに直接オーディオを送信し、ローカルで再生しないのかと思うかもしれません。簡単に言うと、TCPはリアルタイムのオーディオデータを送信するのに適していないため、クライアント側のネットワーク条件が理想的でない場合、翻訳されたオーディオをかなり遅延して聞くことになるからです。エクスペリエンス・コンポーザーAPIを使えば、個々のユーザーのネットワークに依存する必要がなくなる。したがって、この場合のExperience Composerは、サーバーから翻訳されたオーディオを受信し、通話に再生することを仕事とするユーザーと考えることができる。
サーバーは、Audio Connect APIからWebSocket経由でビデオセッションの音声を受信し、音声認識、翻訳、音声合成処理のためにGoogleに送信するミドルウェアである。
オーディオデータを受信するために、オーディオコネクタAPIインスタンスを起動できるAPIエンドポイントを公開します。この start streamingエンドポイントは startStreamer関数を呼び出します。 streamIdまた、オーディオデータを受信するウェブソケットの URL も渡します。この API は、ユーザーがセッションへのパブリッシュを開始すると、クライアント側から呼び出されます。また、Experience Composerインスタンスをインスタンス化します:
app.post('/startStreaming', async (req, res) => {
    try {
        console.log('someone wants to stream');
        const {
            streamId,
            sessionId
        } = req.body;
        console.log(streamId, sessionId);
        const response = await startStreamer(streamId, sessionId);
        const render = await createExperienceComposer(process.env.sessionId);
        if (render && response) {
            return res.send(response);
        }
        res.send(response);
    } catch (e) {
        console.log(e);
    }
});
const startStreamer = async (streamId, sessionId) => {
    try {
        const {
            token
        } = await opentok.generateToken(sessionId, 'publisher');


        const data = JSON.stringify({
            sessionId: sessionId,
            token: token,
            websocket: {
                uri: `${process.env.websocket_url}/socket`,
                streams: [streamId],
                headers: {
                    from: streamId,
                },
            },
        });
        const config = {
            method: 'post',
            url: `https://api.opentok.com/v2/project/${process.env.VIDEO_API_API_KEY}/connect`,
            headers: {
                'X-OPENTOK-AUTH': await generateRestToken(),
                'Content-Type': 'application/json',
            },
            data: data,
        };
        const response = await axios(config);
        console.log(response.data);
        return response.data;
    } catch (e) {
        console.log(e);
        return e;
    }
};
音声データをサーバーで受信するには、Vonageが生の音声データを送信できるように、ウェブソケットをセットアップする必要があります。Googleとのストリーミング・クライアント接続を、1ユーザーにつき1つ初期化します。
app.ws('/socket', async (ws, req) => {
    console.log('someone connected');
    console.log(`starting connection for user with streamId ${streamId}`)
    const uuid = req?.query?.uuid
    let sc = new StreamingClient(uuid, 'es', 'en-US');
    await sc.init();
    const aWss = expressWs.getWss().clients;


    sc.setAudioChunkAvailableCallback(function(chunk) {
        console.log('audio available. Sending audio to the clients connected to the wss');


        const aWss = expressWs.getWss('/socket').clients;
        if (ws.readyState === 1) {
            aWss.forEach(function(client) {
                client.send(chunk);
            });
        }
    });


    sc.setTranscriptionAvailableCallback(function(data) {
        console.log(‘Sending original and translated captions to the connected clients’);
        const aWss = expressWs.getWss('/socket').clients;
        aWss.forEach(function(client) {
            client.send(JSON.stringify(data));
        });
    });
    sc.startRecognizer();
    ws.on('message', (msg) => {
        try {
            if (typeof msg === 'string') {
                let config = JSON.parse(msg);
                console.log(config);
                sc.setId(config.from);
            } else {
                console.log(‘Sending audio data to Google
                    for Speech to text recognition’);
                sc.sendMessage(msg);
            }
        } catch (err) {
            console.log('[' + uuid + '] ' + err);
            ws.removeAllListeners('message');
            ws.close();
        }
    });


    ws.on('close', () => {
        console.log('[' + uuid + '] Websocket closed');
        sc.closeConversation();
        sc = null;
    });
});
の実装を見ることができます。 createExperienceComposerこの ファイル.APIでリクエストを認証するには、JWTトークンを作成する必要があります。 認証ドキュメント.私は jsonwebtoken パッケージを使用しました。の jsonwebtoken パッケージを使いましたが、他のパッケージも自由に使ってください。CreateRender`と`deleteRender`はexperience composerのインスタンスを起動したり停止したりするための関数です。
エクスペリエンス・コンポーザーのインスタンスを作成するには、ドキュメントにあるように、JSONボディにいくつかのパラメータを渡す必要があります。いくつかのパラメータは必須です。 url, sessionId, tokenや projectId.URL パラメータには特に注意してください。これは、エクスペリエンス・コンポーザーが表す「見えないユーザー」がアクセスするURLだと考えてください。その後、Javascriptのコードがロードされ、エクスペリエンス・コンポーザーは新しいストリームをsessionIdにパブリッシュする。
を含むオブジェクトが追加されていることにお気づきだろうか。 propertiesが追加されていることにお気づきだろう。 nameパラメーターが含まれていることにお気づきだろう。この名前は streamCreatedイベントをリッスンするときに役立ちます。これについてはまた後で説明しますが、今のところ知っておく必要があるのは、これがセッションに発行するストリームの名前だということだけです。
app.get('/ec', (req, res) => {
    const options = {
        root: path.join(__dirname),
    };
    res.sendFile('public/ec.html', options);
});
Google コネクタの完成したサンプルコードは このリポジトリ.しかし、簡単に説明しましょう。Google との接続を開始するメインの関数は startRecognised です。ソース言語、モデル、エンコーディングを含む config オブジェクトを定義する必要があります。パラメータについてはサンプルコードを参照してください。
startRecognizer() {
    const config = {
        encoding: encoding,
        sampleRateHertz: sampleRateHertz,
        model: model,
        enableAutomaticPunctuation: true,
        languageCode: this.language,
    };

    const request = {
        config: config,
        interimResults: true,
    };

    this.recognizeStream = this.speechClient.streamingRecognize(request);
    this.recognizeStream.on('data', async (data) => {
        let originalText = data.results\[0].alternatives\[0].transcript;
        console.log('\[' + this.id + ']\[User]' + originalText);
        let translatedText = await this.translate(originalText);
        if (this.transcriptAvailableCallback) {
            this.transcriptAvailableCallback({
                original: originalText,
                translated: translatedText,
                id: this.id,
            });
        }
        this.getAudioData(translatedText);
    });

    this.recognizeStream.on('error', (err) => {
        console.error(err);
        this.tryEndAudioStream();
        if (this.errorCallback) {
            this.errorCallback(err);
        }
    });

    this.recognizeStream.on('finish', (res) => {});
    console.log('\[' + this.id + '] Stream Created');
    this.waitingRestart = false;
    return this.recognizeStream;
}
Googleが音声を書き起こしたら、それを 翻訳APIを使って音声データに変換します。 音声合成API.これは、テキストをターゲット言語に翻訳するために使用されるtranslateメソッドの定義です。
async translate(text) {
    let output = '';
    try {
        let [translations] = await this.translationClient.translate(text, this.outputLanguage);
        translations = Array.isArray(translations) ? translations : [translations];
        translations.forEach((translation, i) => {
            output += `${translation}`;
        });
    } catch (err) {
        console.log(err);
    }
    console.log(output);
    return output;
}
最後に、テキストを翻訳したら、playTTSメソッドを呼び出して、翻訳されたテキストから音声データを取得します。音声はまだ再生されません。翻訳されたテキストを音声データに変換しているだけです。リクエストオブジェクトはエンコーディングやVoiceなどいくつかのパラメータを受け取ります。カスタマイズするには Google音声合成のドキュメント
async getAudioData(text, isSessionEnding = false) {
    try {
        this.sessionEnding = isSessionEnding;
        const request = {
            input: {
                text: text
            },
            voice: {
                languageCode: this.outputLanguage,
                ssmlGender: 'NEUTRAL'
            },
            audioConfig: {
                audioEncoding: encoding,
                sampleRateHertz: sampleRateHertz,
            },
        };
        const [response] = await this.ttsClient.synthesizeSpeech(request);
        if (this.audioChunkAvailableCallback) {
            this.audioChunkAvailableCallback(response.audioContent);
        }
    } catch (err) {
        if (this.errorCallback) {
            this.errorCallback(err);
        }
    }
}
要約すると、リアルタイムビデオ翻訳の導入は、単に言語の障壁を取り除くだけでなく、グローバルコミュニケーションの可能性という全く新しい次元を解き放つのです。あなたはどんな新しいものを作りますか?どんな新機能があればワクワクしますか?私たちのVonageコミュニティSlackまたは X(旧 Twitter.
本記事および対応する Github リポジトリに記載されているアプリケーションロジック、コンポーネントアセンブリ、API コールフローは、係属中の Vonage 特許の請求項の一部です。このリファレンス・ソース・コードとアプリケーション・ロジックは、Vonage Video APIと音声認識、翻訳、音声合成などのAIサービス・プロバイダを使用することで、あなた自身の商用展開に使用することができます。