シェア:

Juliaは、チュートリアル、ガイド、実用的なリソースを作成することで、仲間の開発者に力を与えることに尽力しています。アウトリーチと教育のバックグラウンドを持つ彼女は、テクノロジーをより身近なものにし、開発者の経験全体を向上させることを目指しています。地域のコミュニティイベントでもよく見かける。
「もどかしいチャット対応」から、JevとVonageによるライブVideoサポートへ
所要時間:2 分
チャットボットは、よくある質問に素早く答えるのには非常に優れています。しかし、顧客が行き詰まったり、苛立ちを募らせたり、あるいは単に他の人と話したいと思った場合には、あまり役に立ちません。 ほとんどのチャットボットは、こうした状況を見逃してしまうか、あるいは「それはお気の毒ですね」といった状況にそぐわない返答をした上で、同じ質問を繰り返し、その結果、顧客を失うことになりかねません。
もし、あなたのアプリがその瞬間を検知し、適切なタイミングで人間の担当者を介入させることができたらどうでしょうか?
この記事に沿って、 TypeSafe AIの「Jev」 モデルを基盤として構築します。このモデルは会話の感情状態を継続的に評価し、その後、Video通話を提供します。 Vonage Video API を通じて、状況が思わしくなくなったらすぐにライブビデオ通話を提案します。
AIによる評価ロジックから、不満を抱える顧客を実際に支援できる担当者に結びつけるリアルタイムのシグナリングに至るまで、その仕組み全体を見ていきましょう。
要約: GitHubでリポジトリをフォークして、実際に試してみてください
このアプリには2つの側面があります:
顧客視点: ユーザーが(シミュレートされた)AIサポートエージェントとやり取りを行うチャットインターフェース。
従業員用ダッシュボード: サポート担当者が受信したエスカレーションリクエストを確認できるリアルタイム画面。ユーザーがエスカレーションされた理由の詳細や、Video通話に参加するための「通話に応答」ボタンが表示されます。
これらをつなぐ役割を果たすのが、Node.js/Expressのバックエンドであり、その機能は以下の通りです:
すべての顧客メッセージをTypeSafe AIのJevモデルにかけ、感情や不満の度合いを評価する
構造化されたAIスコアに基づいて、エスカレーションを行うかどうかを決定する
Vonage Video Signaling を利用して、エスカレーション事象を従業員のダッシュボードにリアルタイムで配信します
オペレーターが電話に出た際、ライブ通話用のVonage Videoセッションを開始します
以下に、大まかなアーキテクチャを示します: 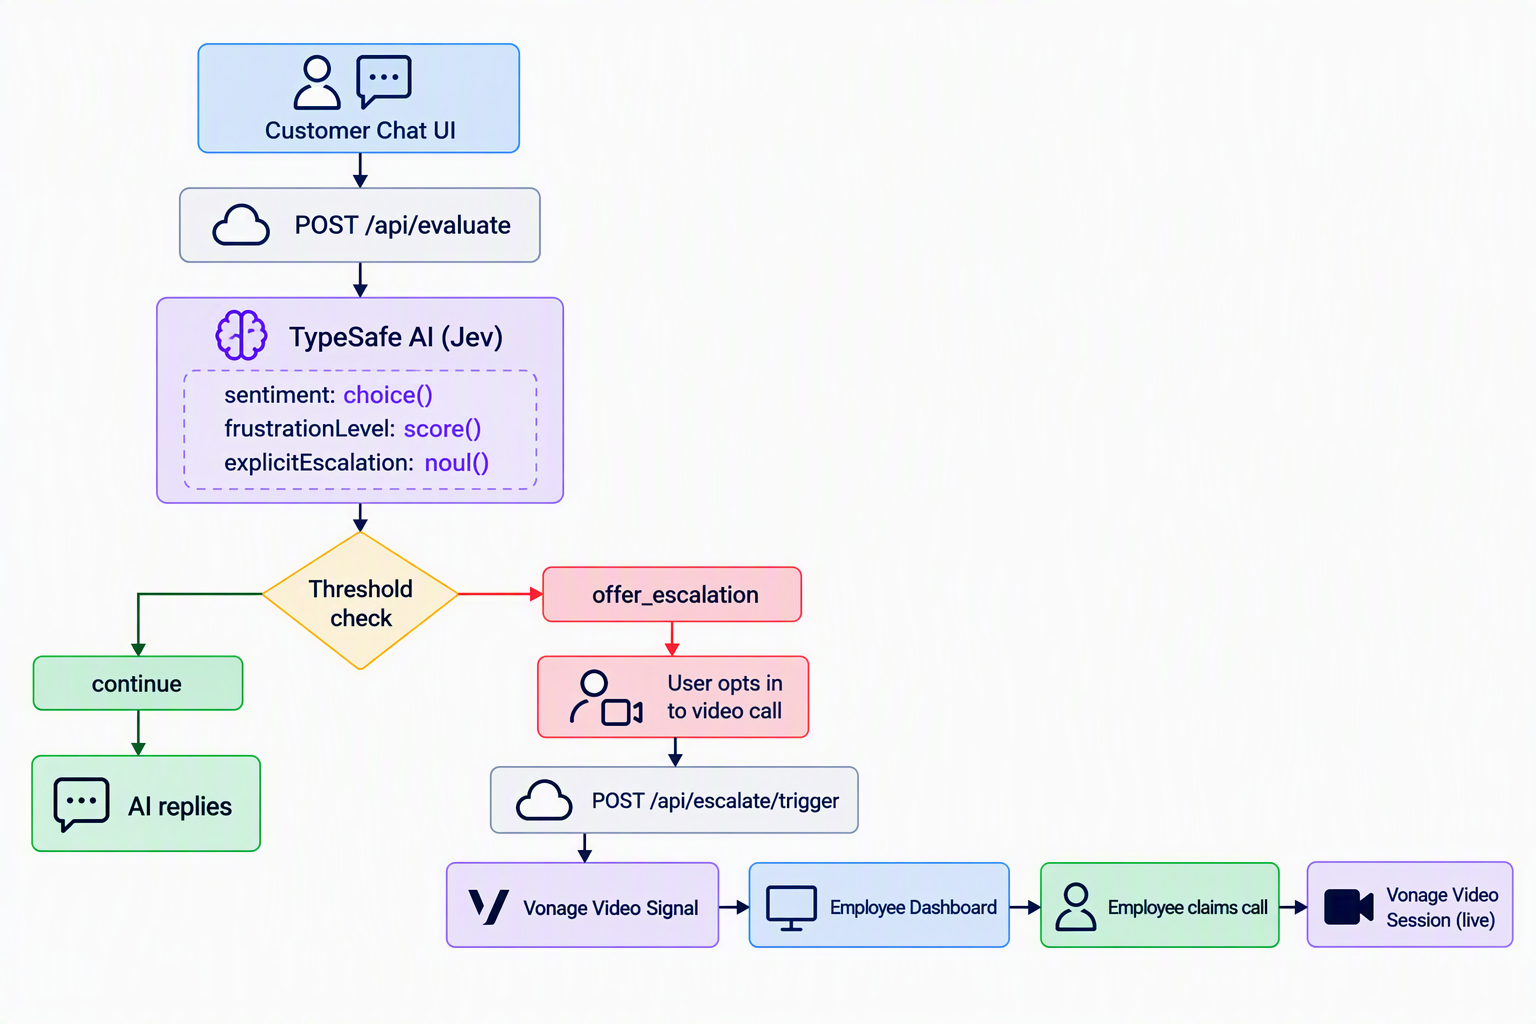
Node.js 22以上
Typesafe AI Account
A GitHub Account
これを実行する最も手っ取り早い方法は、 GitHub Codespacesを使用することです。 ローカルでのセットアップは不要です。
フォーク このリポジトリを GitHubアカウントにフォークする
クリック 「コード」→「コードスペース」→「メイン画面でコードスペースを作成」
同梱の setup.js スクリプトは自動的に実行され、3つのプロンプトに従って操作を進めていきます:
お客様の Vonage APIキー および APIシークレット ( Vonageダッシュボードより)
お客様の TypeSafe AI API キー ( TypeSafe AI コンソールより)
Vonage アプリケーションの名前
セットアップスクリプトは、Vonage API を呼び出してVideo対応アプリケーションを作成し、秘密鍵を保存し、すべての情報を .env ファイルに書き出します。あとは単に npm start。
ここからが興味深いところです。ほとんどの感情分析ツールは、メッセージのテキストをLLMに投入し、応答から自由形式のテキストを解析して抽出します。このアプローチには脆弱性があります。出力形式はさまざまであり、信頼度も不透明で、実質的にはAIが生成した文章に対して文字列照合を行っているに過ぎないのです。
TypeSafe AIの Jev は、異なるアプローチをとっています。テキストでの応答を求める代わりに、ユーザーは 状態 (この場合は会話履歴)を提示し、 型付き質問 (別名 プリミティブ)を提示し、回答形式が制限されたとも呼ばれる)を提示し、回答の形式に制約を設けることができます。
このモデルは、ユーザーの入力内容を評価し、信頼度スコアが組み込まれた、構造化された機械可読な回答を返します。これは、AI推論のための型付きクエリ言語のようなものと考えてください。
利用可能な3つの問題形式は以下の通りです:
機能 | 機能の説明 |
| 事前定義されたラベルのセットの中から1つを、信頼度スコアとともに返す |
| ラベル付き尺度に沿った数値スコアを返す |
| 「はい/いいえ」の質問に対する確率(0~1)を返します |
以下は、 server.js:
import { TypeSafeClient, score, noul, choice } from '@typesafe-ai/sdk';

const jev = new TypeSafeClient(); // reads TYPESAFE_API_KEY from .env

const evaluation = await jev.systemOne({
  state: messages, // the full conversation history
  questions: {
    sentiment: choice("What is the user's current sentiment?", {
      happy: null,
      neutral: null,
      confused: null,
      frustrated: null,
      angry: null
    }),
    frustrationLevel: score("How frustrated is the user?", [
      "Calm, neutral, or happy",            // 0
      "Slightly annoyed but polite",        // 1
      "Visibly frustrated or impatient",    // 2
      "Extremely angry, aggressive, or rude" // 3
    ]),
    explicitEscalation: noul("Does the user explicitly ask to speak to a human, agent, or representative?")
  }
}); ここで注目すべき点がいくつかあります:
会話の履歴全体が状態として渡されます。 つまり、Jevは 「軌跡」を評価することを意味します。2メッセージ前は中立的だったが、現在は苛立ちを感じているユーザーは、最初から一貫して苛立ちを感じていたユーザーとは評価が異なり、その文脈はサポートApplicationsにおいて重要です。
choice() ラベルと信頼度スコアの両方を返します。 評価結果として、evaluation.answers.sentiment.choice(例:「frustrated」)と evaluation.answers.sentiment.confidence(例:0.91)が返されます。これにより、感情状態ごとに異なる閾値を設定し、信頼度の低い推測に基づいて行動することを回避できます。
score() 連続的な尺度に沿った数値を返します。単に最も近いラベルを返すだけではありません。スケールには4つの名前付きポイントがありますが、モデルは浮動小数点数を返します。これにより、スコア1.7のような「中間」の状態(「フラストレーション」に近づいているが、まだその段階には達していない)を捉え、より微妙な判断を下すことが可能になります。
noul() 確率に関する問題に特化して設計されています。 このモデルは、単に「はい」または「いいえ」と答えるのではなく、0から1の間の尤度値を返します。このデモでは、0.8を超えるスコアは、人間による対応が明確に必要であるという確定したリクエストとして扱われます。
評価結果が返されると、サーバーはしきい値チェックを実行します:
const userSentiment = evaluation.answers.sentiment.choice;
const userSentimentConfidence = evaluation.answers.sentiment.confidence;
const frustrationScore = evaluation.answers.frustrationLevel.score;
const wantsHuman = evaluation.answers.explicitEscalation.noul > 0.8;

if (
  frustrationScore >= 2 ||
  (['frustrated', 'angry'].includes(userSentiment) && userSentimentConfidence > 0.8) ||
  wantsHuman
) {
  // Offer escalation
  return res.json({
    action: 'offer_escalation',
    sentiment: userSentiment,
    frustrationLevel: frustrationLevel,
    lastMessage: messages[messages.length - 1].text,
    message: wantsHuman || userSentiment === 'angry'
      ? "I'll connect you to a live agent."
      : "It seems like you might need more help than I can offer. Would you like to connect with a live agent?"
  });
}

// Otherwise, pass to the AI agent to continue the conversation
return res.json({ action: 'continue' }); これら3つのエスカレーションのトリガーは、それぞれ異なるケースを対象としています:
frustrationScore >= 2: ユーザーの苛立ちの兆候を捉える:短い返答、同じ質問の繰り返し、苛立ちが表れている様子など。たとえユーザーが明示的に不快感を示していなくても
感情+確信度: モデルが、ユーザーが苛立ちや怒りを感じていると確信した場合に高まり、言語そのものに表れる感情的なニュアンスに基づいて反応する
wantsHuman: 「誰かと話せますか?」や「生身の人と話したい」といった直接的なリクエストを捕捉します。
Jevへの呼び出しが完全に失敗した場合(ネットワークエラー、APIの問題など)、サーバーは { action: 'continue' } を返します。チャット機能は中断されることなく、エスカレーションされることなく通常通り動作し続けます。
顧客がビデオ通話への参加を承諾すると、アプリは2つの処理を行う必要があります。それは、従業員のダッシュボードへの通知と、実際のビデオセッションの設定です。これら2つの処理は、いずれもVonageが担当します。
このアプリでは、2種類のVonage Videoセッションを使用しています:
顧客セッション は顧客ごとに一意であり、ユーザーがアプリを初めて起動した際にオンデマンドで作成されます。これには パブリッシャートークンが付与されているため、各ユーザーはすぐにそれぞれのVideoセッションに参加できるようになっています。
app.get('/api/auth/customer', async (req, res) => {
  const session = await vonage.video.createSession({ mediaMode: 'routed' });
  const token = vonage.video.generateClientToken(session.sessionId, {
    role: 'publisher'
  });
  res.json({
    applicationId: process.env.VONAGE_APPLICATION_ID,
    sessionId: session.sessionId,
    token: token
  });
}); ディスパッチ・セッション は、すべての従業員が サブスクライバーとして接続する単一の共有セッションですとして接続する単一の共有セッションです。このセッションではVideoは伝送されず、ダッシュボード全体にエスカレーションイベントをリアルタイムで配信するための、純粋なシグナリングチャネルとして機能します。
app.get('/api/auth/dispatch', async (req, res) => {
  const dispatchSessionId = await getDispatchSessionId();
  const token = vonage.video.generateClientToken(dispatchSessionId, {
    role: 'subscriber'
  });
  res.json({ applicationId, dispatchSessionId, dispatchToken: token });
}); このようにして、永続的で低コストなセッションを通知バスとして利用し、実際のVideoセッションは個々の通話ごとに分離して管理しています。
顧客が「オペレーターにつないで」をクリックすると、クライアントは /api/escalate/triggerにPOSTリクエストを送信します。その後、サーバーは Vonage Video Signaling を使用して、ディスパッチセッションに登録されている全員(従業員)にエスカレーションイベントをブロードキャストします:
await vonage.video.sendSignal({
  type: 'escalation',
  data: JSON.stringify({
    customerId,
    sessionId,       // the customer's unique video session
    sentiment,
    frustrationLevel,
    lastMessage
  })
}, dispatchSessionId); 各従業員のブラウザはこのシグナルを受信し、顧客の感情的な状況(感情ラベル、フラストレーションレベル、最後のメッセージ)と「通話に応答」ボタンを併記したダッシュボードカードを表示します。
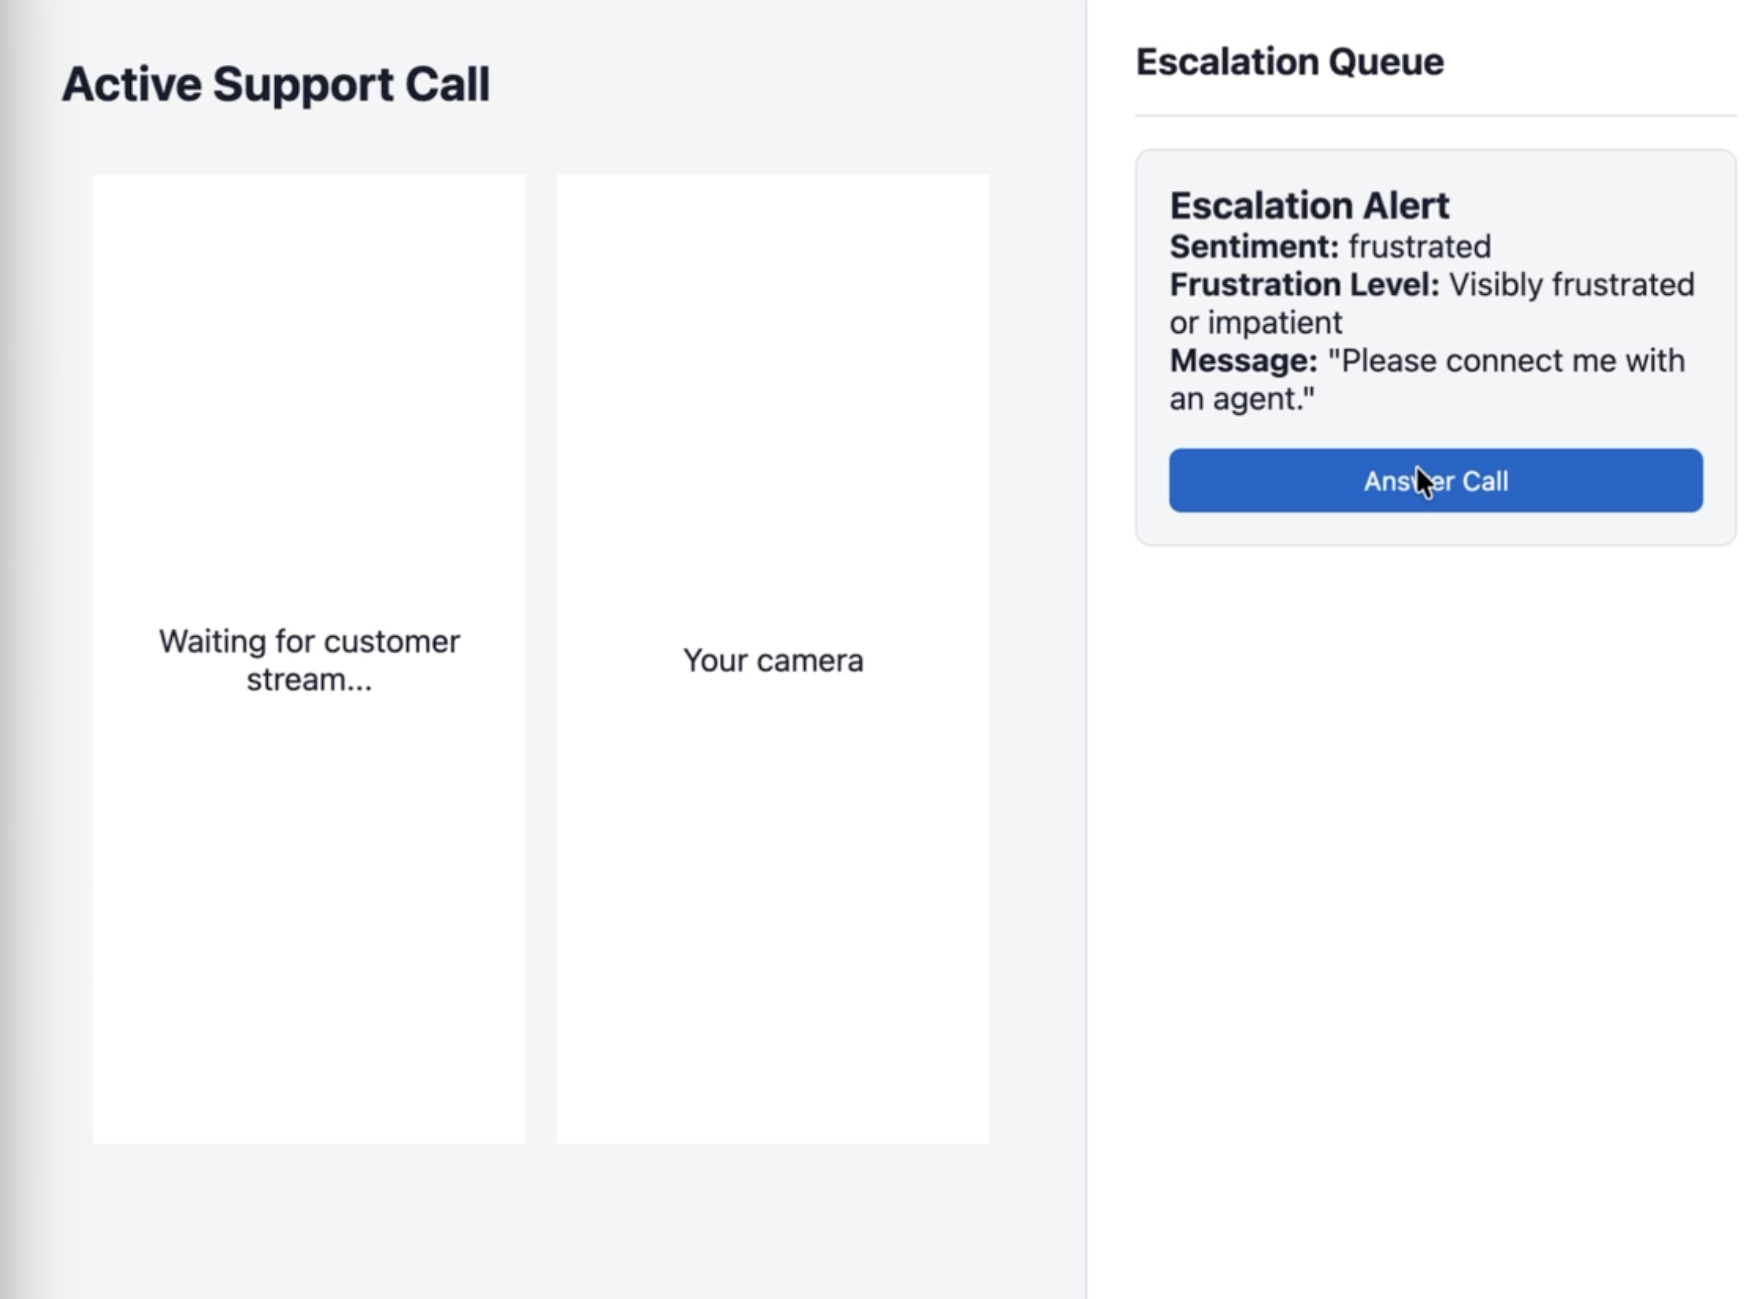 Employee Dashboard Showing Escalation Queue
従業員が「通話に応答」をクリックすると、次の2つのことが起こります:
A
claimedディスパッチセッションにシグナルが送信されるため、他の従業員のダッシュボードからそのカードが削除される従業員は、その顧客の特定のVideoセッション用のパブリッシャートークンを受け取り、通話に参加します
// Claim the call — remove it from other dashboards
await vonage.video.sendSignal({
  type: 'claimed',
  data: JSON.stringify({ customerId })
}, dispatchSessionId);

// Join the customer's session as a publisher
const token = vonage.video.generateClientToken(sessionId, { role: 'publisher' }); 顧客側では、UIは標準的な <dialog> 要素で構成されており、2つのVideoコンテナが含まれています。1つは顧客自身のパブリッシャーフィード用、もう1つは従業員のサブスクライバーストリーム用です。
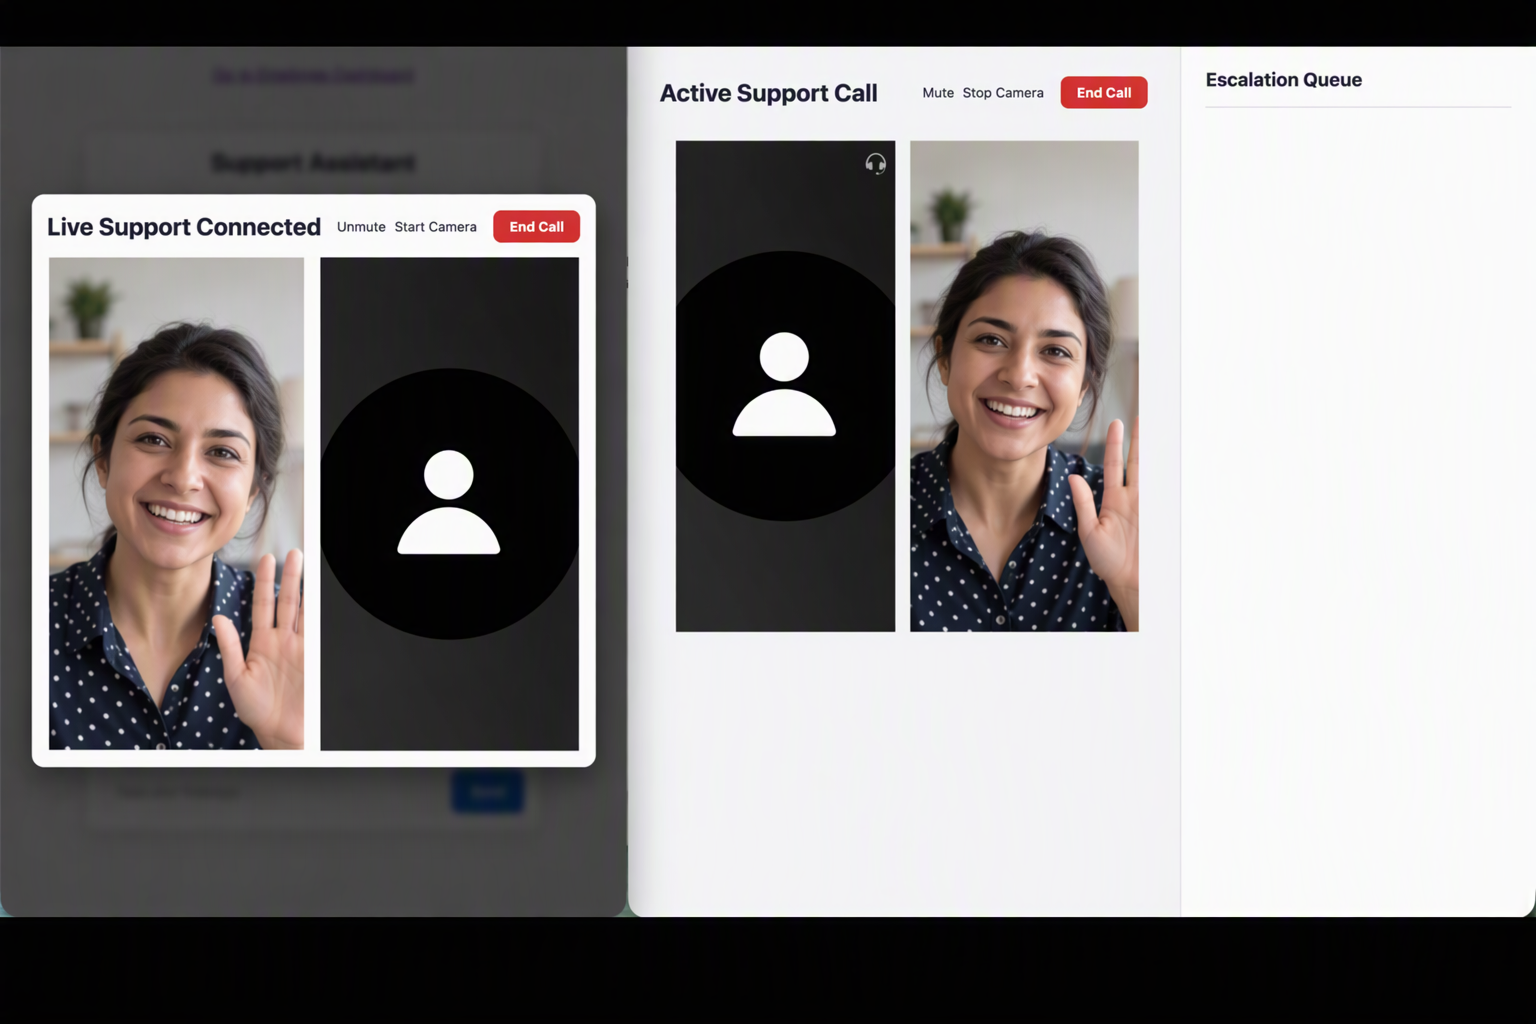 Screenshot of Customer View and Employee Dashboard Side by Side
不満を抱えた顧客からライブVideo通話に至るまでの全過程は、以下の通りです:
顧客がチャットメッセージを送信 → クライアントが会話履歴をPOSTで送信
/api/evaluateサーバーは、以下の方法を通じて、完全な履歴をJevに渡します。
jev.systemOne()- 感情、フラストレーションスコア、エスカレーション確率を取得するサーバーは、スコアを閾値と照らし合わせて評価します。いずれかの閾値を超えた場合、以下のアクションを返します:
'offer_escalation'顧客が承諾 → クライアントが以下へPOSTを送信
/api/escalate/triggerサーバーは、顧客のセッションIDと感情のコンテキストを含むディスパッチセッション上で、Vonage Video信号を送信します。
従業員のブラウザが信号を受信する → ダッシュボードにカードが表示される
従業員が「通話に応答」をクリック → サーバーがブロードキャストを行い
claimed、顧客のセッション用のパブリッシャートークンを返す現在、両者は同じVonage Videoセッションに参加しています
このリポジトリは、GitHub Codespaces を使用して、ゼロから5分以内に動作するデモを作成できるように設計されています:
フォーク: https://github.com/Vonage-Community/demo-video-javascript-jev-starter
Codespacesで開く → 実行
setup.js自動的にVonage + TypeSafe AI の認証情報を追加してください
npm start
サーバーが起動したら、ブラウザのタブを2つ開いて(1つは顧客用ビュー、もう1つは従業員用ダッシュボード用)、例えば「もう3回も説明したのに、誰も助けてくれない」といった内容を入力してみてください。Jevがどのような結果を返すか、そしてダッシュボードがどのように反応するかを確認してください。
このデモは、あえて「出発点」として用意したものです。次に試してみる価値のある方向性をいくつかご紹介します:
このデモの興味深い点は、単にビデオ通話が行われることだけでなく、それをトリガーする意思決定レイヤーにあります。Vonage VideoのリアルタイムシグナリングとTypeSafe AIの構造化された評価を組み合わせることで、エスカレーションロジックが明示的で、調整可能、かつデバッグ可能になります。 自由形式のLLMの応答から感情を解析して、うまくいくことを願うのではなく、型付けされた質問でモデルにクエリを実行し、構造化された回答を得ることができるのです。
これは、さらに発展させる価値のあるパターンです。この評価ループを活用すれば、先を見越したサポート対応、チケットの優先順位付けの自動化、あるいはエージェントとの会話の品質モニタリングなどが可能になります。自然言語から信頼性が高く、実用的なシグナルをリアルタイムで抽出する必要がある場面であれば、ぜひ試してみてください。
ご質問がある場合、またはあなたが作っているものを共有したい場合は、こちらをクリックしてください。
登録する 開発者ニュースレター
フォローする X(旧ツイッター)最新情報
Videoの方がいいですか? 当社の YouTubeチャンネルでチュートリアルをご覧ください
LinkedInの LinkedIn の Vonage デベロッパーページ
開発者体験の向上にご協力ください。以下の 「開発者の声」フィードバックにご協力ください
最新の開発者向けニュース、ヒント、イベント情報をお届けします。