Post-Call-Transkriptionen
Sie können eine Text-Transkription für ein Video API-Archiv abrufen.
Diese Seite enthält die folgenden Abschnitte:
- Überblick über die Funktionen
- Transkription und Zusammenfassung beim Starten eines Archivs aktivieren
- Abrufen des Transkriptionsstatus
- Format der Transkription
- Transkriptionen herunterladen
- Einschränkungen/Bekannte Probleme
- FAQs
Überblick über die Funktionen
Die Server der Vonage Video API erstellen nach dem Anruf Transkripte mithilfe künstlicher Intelligenz und anderer modernster Technologien.
Sie aktivieren Transkriptionen, wenn Sie ein Archiv über die REST-API starten.
Nach Abschluss der Archivaufzeichnung wird die Transkription als JSON-Datei zur Verfügung stehen.
Transkription und Zusammenfassung beim Starten eines Archivs aktivieren
Wenn Sie mit der Vonage Video REST API ein Archiv starten, setzen Sie die hasAudio und hasTranscription Eigenschaften zu true in den JSON-Eigenschaften, die Sie an die Startarchiv-REST-Methode gesendet haben:
Außerdem können Sie eine optionale transcriptionProperties Objekt mit einer hasSummary (boolesch) und/oder primaryLanguageCode (String) Eigenschaften. Bei der Einstellung hasSummary auf true gesetzt, wird eine von der KI erstellte Zusammenfassung in die Transkription aufgenommen. Wenn sie auf false gesetzt ist oder fehlt (Standardwert ist false), wird die Transkriptionszusammenfassung nicht aufgenommen. Wenn die Transkription für eine andere Sprache als "en-US" (Standard) ist, konfigurieren Sie die Eigenschaft primaryLanguageCode mit einer Unterstützter Sprachcode.
Satz outputMode (in den POST-Daten) an "individual". Transkriptionen sind verfügbar für einzelne Stream-Archive nur.
Legen Sie den Wert für api_key für Ihren OpenTok-Projekt-API-Schlüssel. Legen Sie den Wert für json_web_token zu einem JSON-Web-Token (siehe die REST-API-Authentifizierung Dokumentation).
Weitere Archivierungsoptionen finden Sie in der Dokumentation zum Programm Archiv REST-Methode starten.
Die Antwort auf einen Aufruf der REST-Methode start archive enthält hasTranscription und transcription Eigenschaften zusätzlich zu den anderen dokumentierten Eigenschaften der Antwort:
{
  "createdAt" : 1384221730555,
  "duration" : 0,
  "hasAudio" : true,
  "hasVideo" : true,
  "id" : "b40ef09b-3811-4726-b508-e41a0f96c68f",
  "name" : "The archive name you supplied",
  "outputMode" : "individual",
  "projectId" : 123456,
  "reason" : "",
  "resolution" : "640x480",
  "sessionId" : "flR1ZSBPY3QgMjkgMTI6MTM6MjMgUERUIDIwMTN",
  "size" : 0,
  "status" : "started",
  "streamMode" : "auto",
  "hasTranscription" : true,
  "transcription" : {
    "hasSummary": true,
    "primaryLanguageCode": "ja-JP",
    "reason": "",
    "status": "requested",
    "url": ""
  }
}
Siehe Abrufen des Transkriptionsstatus für Informationen zum dynamischen Abrufen der Transkriptionsdetails.
In einem automatisch archivierte Sitzungwird die Transkription nicht automatisch gestartet. Sie sollten ein zweites Archiv starten, indem Sie die multiArchiveTag für die Transkription (siehe Gleichzeitige Archive).
Die Unterstützung für Transkriptionen ist derzeit über die Vonage Video REST-API verfügbar. In den Vonage Video-Server-SDKs wird sie nicht unterstützt.
Abrufen des Transkriptionsstatus
Die Antwort für die REST-Methoden für Angebotsarchiv und Abrufen von Archivinformationen wird umfassen hasTranscription und transcription Eigenschaften:
{
    "id" : "b40ef09b-3811-4726-b508-e41a0f96c68f",
    "event": "archive",
    "createdAt" : 1723584124,
    "duration" : 328,
    "name" : "the archive name",
    "projectId" : 123456,
    "reason" : "",
    "sessionId" : "2_MX40NzIwMzJ-flR1ZSBPERUIDIwMTN-MC45NDQ2MzE2NH4",
    "size" : 18023312,
    "status" : "uploaded",
    "hasTranscription" : true,
    "transcription": {
      "status": "available",
      "url": "URL for downloading the transcription, if available",
      "reason": "The reason for failure, if status is set to failed",
      "hasSummary": true,
      "primaryLanguageCode": "The configured language code"
    }
}
Die hasTranscription ist eine boolesche Eigenschaft, die angibt, ob die Transkription für das Archiv aktiviert ist.
Die transcription Eigenschaft ein Objekt mit den folgenden Eigenschaften:
-
status(String) - Der Status der Transkription, der auf einen der folgenden Werte gesetzt werden kann:"requested"- DiehasTranscriptionEigenschaft wurde festgelegt auftruebeim Aufruf des Startarchivs, aber die Transkription hat noch nicht begonnen."failed"- Die Transkription ist fehlgeschlagen. Prüfen Sie diereasonEigenschaft für weitere Informationen."started"- Die Transkription ist in Arbeit."available"— Die Transkription steht auf OpenTok zum Download bereit. Schauen Sie unterurlEigentum."uploaded"- Die Transkription steht in dem S3-Bucket oder Azure-Container, den Sie in Ihrem Video API Account angegeben haben, zum Download bereit. Suchen Sie im Archiv-ID-Ordner in Ihrem Archivspeicherziel nach einer transcription.zip. Siehe Archivierung.
-
url(Zeichenkette) — Die URL zum Herunterladen der Transkription, falls diestatuswird eingestellt auf"available". -
reason(String) - Der Grund für das Scheitern der Transkription, wenn diestatuswird eingestellt auf"failed". -
hasSummary(Boolean) - Gibt an, ob eine von der KI erstellte Zusammenfassung in der Transkription enthalten ist. -
primaryLanguageCode(String) - Der für die Transkription konfigurierte Sprachcode.
Sie können auch einen Archivstatus-Callback für Ihr Video API Account. Siehe Archivstatusänderungen. Die Rückrufdaten enthalten auch hasTranscription und transcription Eigenschaften.
Format der Transkription
Die Transkription wird in Form einer komprimierten ZIP-Datei bereitgestellt. Die unkomprimierte Datei ist eine Textdatei mit JSON-Daten.
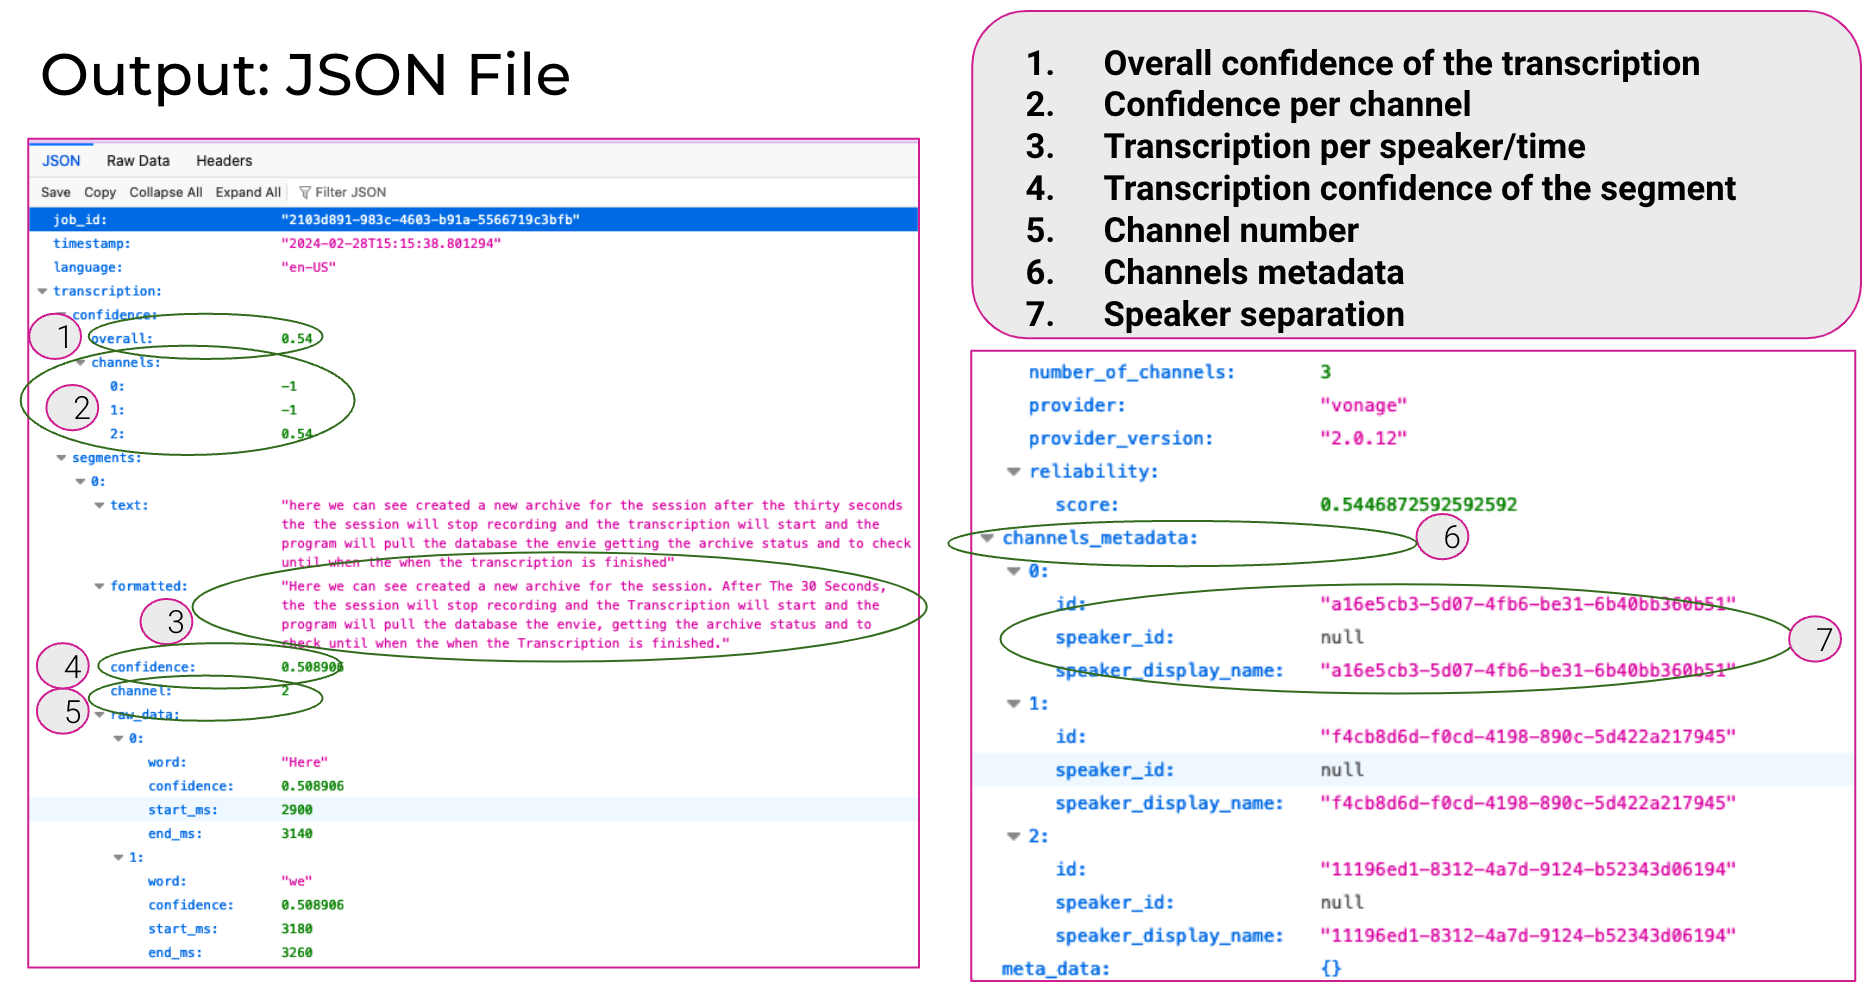
Die Transkription umfasst einzelne Textsegmente. Jedes Segment entspricht einem einzelnen Audiokanal (aus einem der Audiostreams der Sitzung).
Das JSON hat die folgenden Top-Level-Eigenschaften:
-
job_id- Eine eindeutige ID für die Transkription. -
timestamp- Eine ISO 8601-Datumszeichenfolge, die angibt, wann die Transkriptionsdatei erstellt wurde. -
language- Diese ist eingestellt auf"en-US". -
channels_metadata- Ein Array von Objekten, die jeden Audiokanal definieren. Jedes Objekt einidEigenschaft, bei der es sich um die OpenTok-Stream-ID handelt. Sie können identifizierende Verbindungsdaten hinzufügen, wenn Sie ein Client-Token erstellen für jeden Benutzer. Sie können verwenden Rückrufe zur Sitzungsüberwachung um die Stream-IDs und die Verbindungsdaten für die einzelnen Stream-Verbindungen zu erhalten. Diese können Sie dann verwenden, um den Benutzer des Streams in der Transkription zu identifizieren. -
transcription— Ein Objekt, das die Transkriptionsdetails enthält (siehe unten).
Die transcription Objekt hat die folgenden Eigenschaften:
-
number_of_channels- Die Anzahl der einzelnen Audiokanäle des Archivs, die in die Transkription einbezogen wurden. -
confidence- Ein Objekt mit zwei Eigenschaften:overallundchannels. Dieoverallist die geschätzte Konfidenz der gesamten Transkription (von 0 bis 1,0). Diechannelsist ein Array, das die geschätzte Konfidenz der einzelnen Kanäle in der Transkription auflistet. -
reliability- Ein Objekt mit einer Eigenschaft:score. Diescoreist eine Zahl, die die geschätzte Gesamtzuverlässigkeit der Transkription angibt (von 0 bis 1,0). -
summary- Wenn Sie die EinstellunghasSummaryEigenschaft dertranscriptionPropertiesObjekt zutruebeim Starten des Archivs ist diese Eigenschaft enthalten. Sie ist auf eine KI-generierte Zusammenfassung der Transkription eingestellt. -
segments— Eine Reihe einzelner Segmente im Transkript.
Jedes Objekt in der segments Das Array weist die folgenden Eigenschaften auf:
-
text- Der transkribierte Text des Segments. -
formatted- Der formatierte Text (mit Interpunktion) des Segments. -
confidence- Eine Zahl zwischen 0 und 1,0, die die geschätzte Zuverlässigkeit der Transkription des Segments angibt. -
channel- Die Ganzzahl, die den Audiokanal für das Segment identifiziert. -
start_ms— Der Versatz des Segmentanfangs gegenüber dem Beginn der Transkription in Millisekunden. -
end_ms— Der Versatz des Segmentendes gegenüber dem Beginn der Transkription in Millisekunden. -
raw_data— Ein Array mit Objekten für jedes Wort im Transkriptionssegment.
Jede raw_data Objekt enthält die folgenden Eigenschaften:
-
word— Ein Wort zu diesem Abschnitt. -
confidence- Eine Zahl zwischen 0 und 1,0, die die geschätzte Sicherheit des transkribierten Wortes angibt. -
start_ms- Der Abstand des Wortanfangs vom Beginn der Transkription in Millisekunden. -
end_ms- Der Abstand zwischen dem Wortende und dem Beginn der Transkription in Millisekunden.
Transkriptionen herunterladen
Es gibt zwei Möglichkeiten, die Transkriptionsdatei für ein Archiv herunterzuladen: über die REST-API oder über das Developer Dashboard.
Herunterladen über die REST-API
Sie können die Transkriptionsdatei für ein bestimmtes Archiv herunterladen, indem Sie die Funktion Abrufen von Archivinformationen REST-Methode und die Überprüfung der transcription.url Eigenschaft in der Antwort. Wenn die transcription.status Eigenschaft wird auf "available" oder "uploaded"die transcription.url enthält eine URL zum Herunterladen der Transkriptionsdatei.
Verwenden Sie eine HTTP-GET-Anfrage, um die Transkriptionsdatei von der URL herunterzuladen. Zum Beispiel:
Herunterladen über das Developer Dashboard
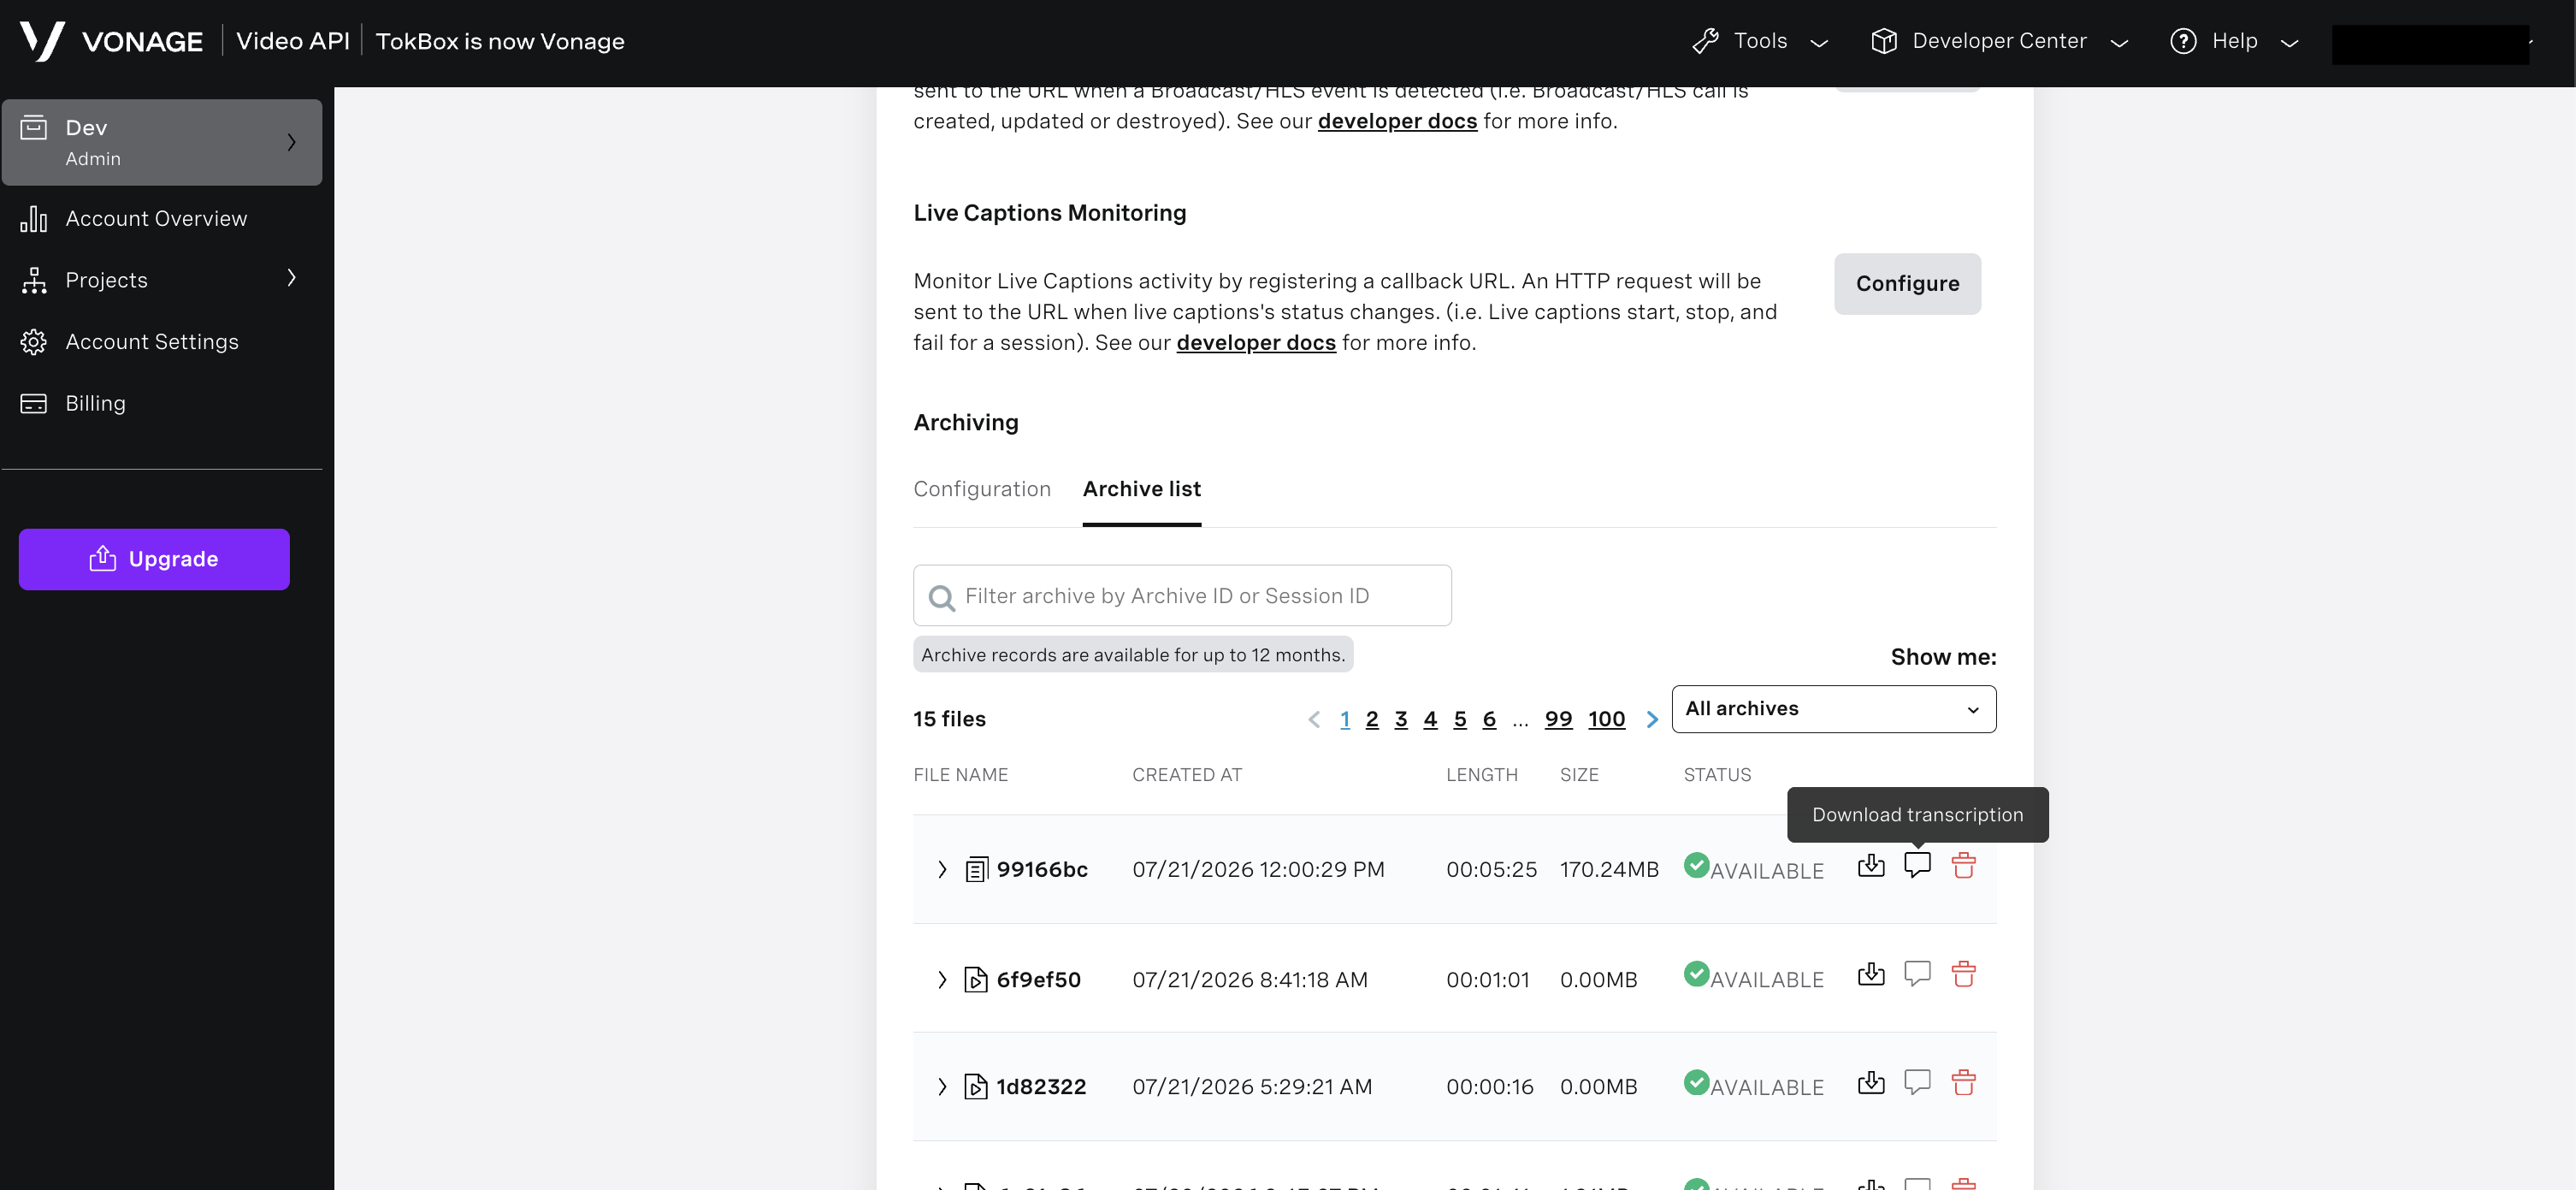
Sie können die Transkription für einen bestimmten Anruf herunterladen, wenn die Ausweichspeicher durch Befolgen dieser Schritte aktiviert wurde:
- Öffnen Sie das Entwickler-Dashboard.
- Wählen Sie ein Projekt aus der Projektliste aus und navigieren Sie zu dem Archivierung Abschnitt. Klicken Sie auf die Archivliste Taste.
- Geben Sie optional ein Archiv-ID oder Sitzungs-ID um die Ergebnisse einzugrenzen.
- Suchen Sie in der Ergebnisliste die entsprechende Sitzung.
- Bewegen Sie den Mauszeiger über das Feld Status Spalte für diese Sitzung und klicken Sie auf die Download Transkription Taste.
Beschränkungen/bekannte Probleme
-
Transkriptionen sind nur für einzelne Stream-Archive verfügbar, nicht für zusammengestellte Archive.
-
Transkriptionen sind nicht mit verschlüsselten Archiven kompatibel.
-
Diese Funktion wird derzeit von der Vonage Video REST API unterstützt, nicht von den Vonage Video Server SDKs.
-
Die maximale Länge einer Abschrift beträgt 120 Minuten.
-
Die Transkription nach dem Anruf entspricht nicht in vollem Umfang den Anforderungen der Regionale Medienzonen (siehe unten).
| Unterstützung für regionale Medienzonen | Während der Alpha-Phase verfügbar | Verfügbar ab der allgemeinen Verfügbarkeit (GA) |
|---|---|---|
| USA | Ja | Ja |
| EU | Ja | Ja |
| Kanada | Nein | Je nach Bedarf |
| Deutschland | Nein | Je nach Bedarf |
| Australien | Nein | Je nach Bedarf |
| Japan | Nein | Je nach Bedarf |
| Südkorea | Nein | Je nach Bedarf |
FAQs
Häufig gestellte Fragen:
Wie viele Datenströme können in einer einzigen Sitzung analysiert werden?
Bis zu 50 Streams mit einer Höchstzahl von 120 transkribierten Minuten.
Funktioniert die Funktion zur Transkription nach dem Anruf sowohl bei weitergeleiteten als auch bei vermittelten Gesprächen?
Die Funktion zur Transkription nach dem Anruf ist für weitergeleitete Sitzungen vorgesehen (Sitzungen, die die Vonage Media-Router).
Wenn das Hochladen der Transkription in einen vom Kunden konfigurierten S3-Bucket fehlschlägt, funktioniert der Wiederholungs- oder Ausweichmechanismus dann ähnlich wie beim Hochladen in das Archiv?
Ja, der Mechanismus für die Wiederholung von PCT funktioniert genauso wie bei regulären Archiv-Uploads.
Muss der Kunde in Fällen, in denen die Transkription zurückfällt und in die Vonage Cloud hochgeladen wird, eine HTTP-GET-Anfrage verwenden, um den Download-Link für die Transkription zu erhalten?
Wenn sich der Transkriptionsstatus ändert, sollte der Kunde einen Rückruf erhalten, der die Download-URL enthält. Wenn kein Callback registriert ist, kann der Download-Link nur über eine HTTP-GET-Anfrage abgerufen werden.
Sobald der Link zum Herunterladen der Transkription eingegangen ist, kann er direkt heruntergeladen werden. Ist die Einführung einer Authentifizierung für das Herunterladen der Transkription geplant?
Es ist nicht geplant, eine Authentifizierung für den Link einzuführen. Der Download-Link hat ein kurzes Verfallsfenster. Wird innerhalb dieses Zeitraums nicht auf ihn zugegriffen, muss eine neue Anfrage gestellt werden, um einen neuen Link zu erhalten.
Obwohl mehrere Benutzer an der Sitzung teilgenommen haben, ist die Transkriptionsdatei eine einzige JSON-Datei. Wie können wir zwischen den Benutzern unterscheiden?
Jeder Transkriptions-Eintrag in der Datei ist mit einer bestimmten Kanalnummer verknüpft, die jedem Stream zugewiesen ist. Die Datei enthält außerdem eine channels_metadata Eigenschaft, die Informationen zur Stream-ID bereitstellt, die der jeweiligen Kanal-ID entspricht.